CHAPTER 24 / 37
学习曲线:是该增加数据,还是该更换模型?
学习曲线的核心价值,不在于解释模型表现,而在于帮助你判断:问题出在数据不足,还是模型本身。
在上一篇中,我们已经建立了一个非常关键的判断框架:一个模型表现不好,本质上只有两种原因:学不会(高偏差),或者学过头(高方差)。
但问题是,当你面对一个真实项目时,这个判断往往没有那么直观。
这时候,有一个非常实用的工具,可以帮助你“看见模型在成长的过程”——学习曲线(Learning Curve)。
学习曲线:不是一张图,而是一个“决策工具”
想象一个更贴近产品的场景:你在做一个用户流失预测模型,目标是预测哪些用户可能在未来7天内流失。
你不断增加训练数据:
用100个用户数据训练
用1000个用户数据训练
用10000个用户数据训练
你会发现一个现象——模型表现,并不是线性变好的。
这个现象可以通过学习曲线来理解,一个典型的学习曲线如下图所示:
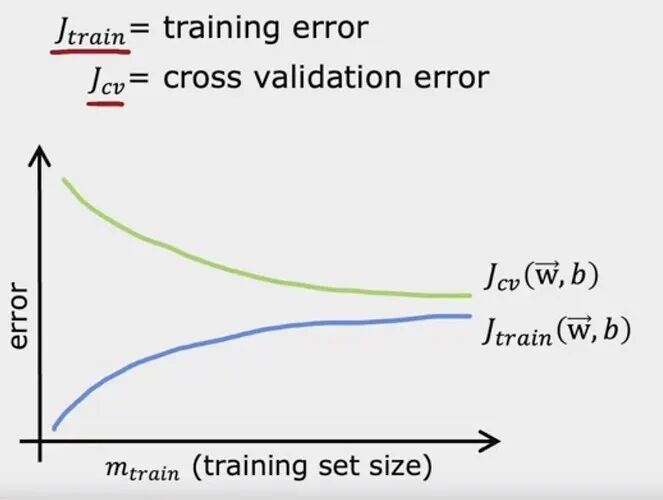
横轴表示训练数据量(m),纵轴表示误差(Error)。
在学习曲线图中,你会看到两条关键曲线:Training Error(训练误差) 和Validation Error(验证误差)。
一个反直觉但极其重要的现象
很多人第一次看到这张图会觉得奇怪:为什么数据越多,训练误差反而变大?
用一个更直观的方式理解是:
当你只有100条数据时,模型很容易“记住”这些数据 几乎可以做到完全拟合,训练误差很低;
而当你有10000条数据时,数据更复杂,模型无法记住每一个细节,此时训练误差反而会上升。
出现这种情况的本质是:数据越少,模型越容易“作弊”;数据越多,模型越必须学规律。
判断问题类型
学习曲线不是用来“看趋势”,而是用来判断到底是偏差问题,还是方差问题?
常见的学习曲线会有3种形态,如下图所示:
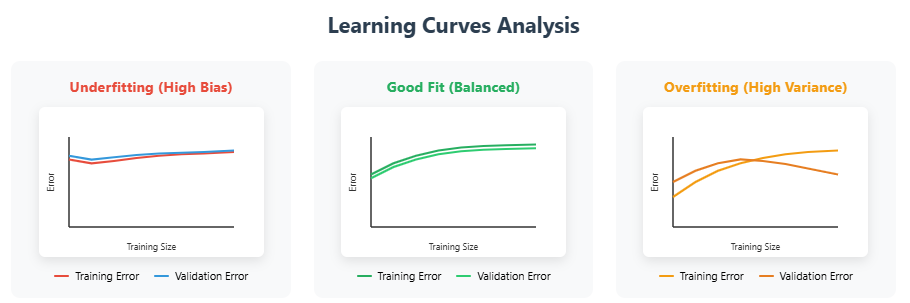
1、高偏差(Underfitting):模型学不会
这种情况的学习曲线如下图所示
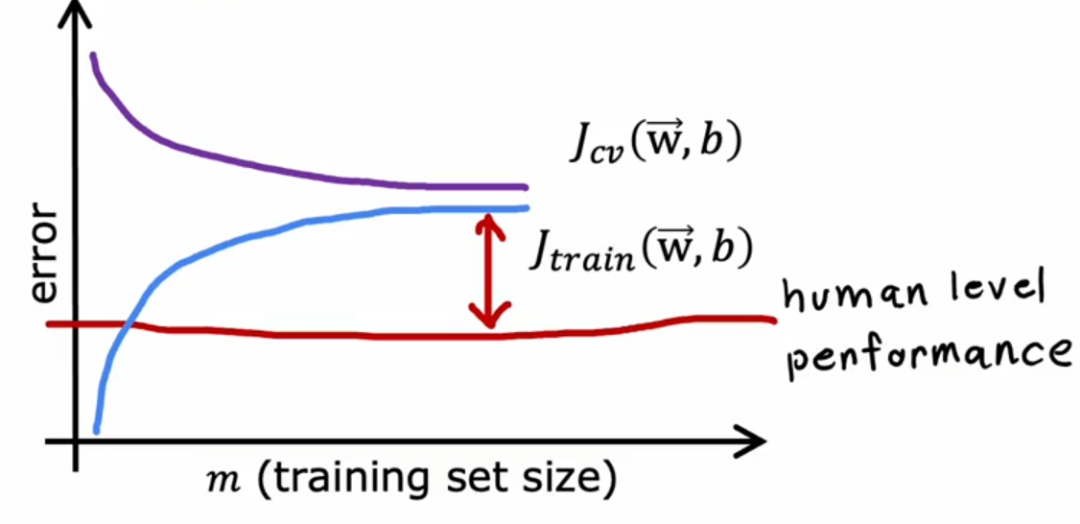
这种情况的特征是,训练误差高,验证误差也高,两条曲线最终很接近。
这种场景意味着,模型本身太弱,结论是,单纯的增加训练数据并不会让模型变得更好。
比如上述案例中,假设你用来预测点击的特征只有用户是否登录,那么正确做法应该是增加特征(行为、兴趣、上下文)来提升模型复杂度,并降低正则化。
2、高方差(Overfitting):模型学过头
这种情况的学习曲线如下图所示:
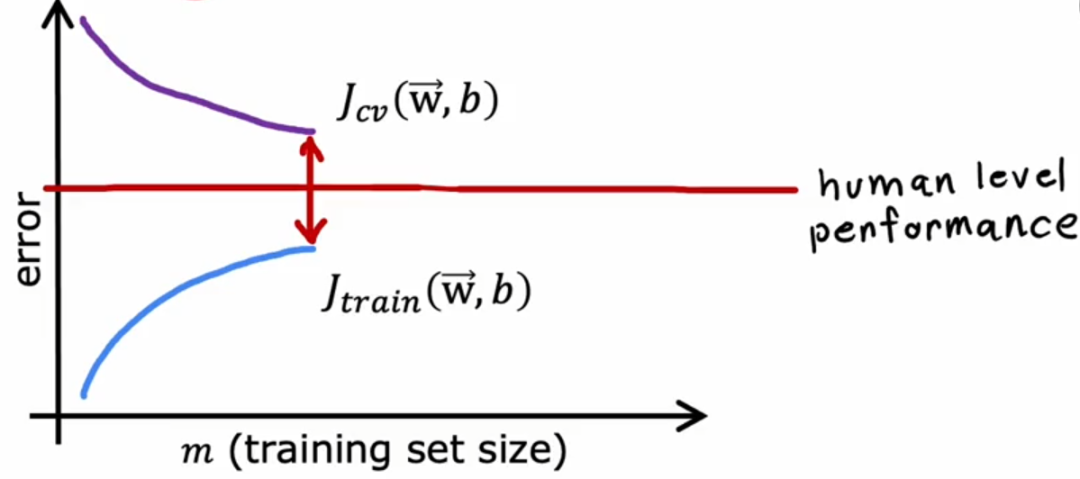
这种情况的特征是,训练误差很低,验证误差很高,两条曲线差距很大。
这意味着这种情况下,加数据非常有效,因此,应该增加数据量(最优解),减少特征,并增强正则化。
3、理想状态
这种状态下,两条曲线都低且接近,这意味着模型既学到了规律,又没有过拟合。
学习曲线的真正价值:帮你决定“下一步动作”
当你看到一条学习曲线之后,你真正要问的,不是“它长什么样”,而是——接下来我该做什么?学习曲线的真正价值是帮你决定下一步动作。
在真实项目中,你通常会面临几种选择:要不要继续收集数据?要不要增加特征?要不要换一个更复杂的模型?要不要调整正则化参数?
这些选择的成本是完全不同的:
收集数据,可能是几周甚至几个月
改模型,可能需要算法资源
加特征,往往需要业务理解
而学习曲线,本质上就是在帮你回答一个问题:哪一条路是值得投入的?
我们可以把刚才三种情况,再往前推一步,变成“行动建议”。
高偏差:不是数据不够,而是模型不行
如果你的学习曲线是“高偏差”,这时候,加数据通常是无效的,因为问题不在于“数据不够”,而在于模型连已有的数据都没学明白。更好的做法是增加特征(让模型看到更多信息)和使用更复杂的模型(比如从线性模型到神经网络),并减小正则化(让模型更“敢学”)。
如果你的学习曲线是“高方差”,这说明模型已经把训练数据“学得很好”,甚至有点过头。这时候最有效的手段,往往不是改模型,而是让模型看到更多不同的数据。因为更多的数据,会迫使模型去学“共性”,而不是“细节”。除了加数据,你还可以减少特征(降低模型自由度)和增强正则化(让模型更“保守”)。
当你看到两条曲线都比较低,且相互接近,这通常说明模型已经达到了一个不错的状态。但这并不意味着“可以结束了”,更准确的说法是:你找到了当前数据和模型条件下的一个平衡点。如果你还想继续提升:要么增加数据,要么引入新的信息(特征),要么改变问题本身的建模方式。
一个很容易被忽略的结论
这里有一个非常反直觉,但非常重要的结论:“多数据一定更好”这句话,只在高方差场景下成立。
换句话说:
高方差 → 加数据有效
高偏差 → 加数据基本没用
这也是为什么,有些团队花了几个月去补数据,效果却没有明显提升。
本质原因是:他们解决的是“数据问题”,但真正的问题在“模型能力”。
如何在实际项目中使用学习曲线?
在工程上,你不需要一次性画出完整曲线。
一个更现实的做法是:用10%的数据训练一次,用30%的数据训练一次,用100%的数据训练一次。
然后观察:训练误差的变化、验证误差的变化以及两者之间的差距。
即使只是这几个点,也足够判断方向。
很多人把机器学习理解为不断调参数:调学习率、调模型结构、调正则化……
但实际上,更重要的是:你是否知道,自己在解决什么问题。
学习曲线的意义,不在于它提供了一种可视化方式,而在于它让模型的行为变得“可解释”。
当你看到一条曲线时,你不再只是看到一个结果,而是能够判断:是能力不够(偏差)还是学过头了(方差),下一步该投入在哪。
从这个角度看,学习曲线的价值,并不在图上,而在于它背后的判断逻辑。
附录:本文涉及的专有名词中英文对照(标红为最核心)