CHAPTER 21 / 37
优化算法与网络结构:神经网络是如何变得更快更强的?
神经网络如何通过更先进的优化算法与新的网络层结构不断进化,从而实现更快的训练速度与更强的学习能力。
在前面的文章中,我们已经介绍了神经网络的几个关键组成部分:
-
前向传播
-
损失函数
-
反向传播
-
梯度下降
这些内容构成了神经网络学习的基本框架。
但如果你真的去训练一个神经网络,会很快发现一个问题:模型学得太慢。有时候需要训练几十轮甚至上百轮,模型才能逐渐接近理想结果。因此,机器学习领域一直在研究一个问题:有没有更聪明的方法,让模型学习得更快?
这一篇,我们会介绍两个重要的进展:
1、更先进的优化算法:Adam
2、不同类型的神经网络层,例如卷积层
梯度下降的问题
在之前的文章中,我们介绍了梯度下降(Gradient Descent)。
它的核心思想其实很简单:如果当前的误差比较大,就沿着“误差下降最快的方向”调整参数。
如下图所示:
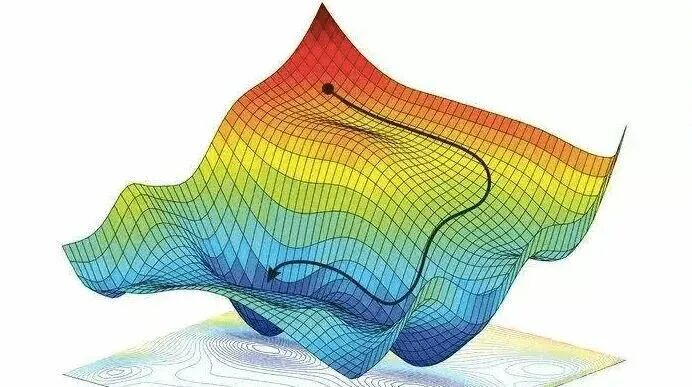
每一次更新参数,模型都会向着误差更小的方向移动一点,但这个方法有两个问题:
1、步子可能太小。模型会像这样慢慢移动:一步、再一步、再一步……需要很多轮训练才能接近最优解。
2、可能来回震荡。如果学习率太大,模型会变成:左一下、右一下、左一下、右一下……一直在最优解附近来回震荡。
Adam:更聪明的优化算法
为了解决这个问题,研究人员提出了一种更先进的优化算法:Adam(Adaptive Moment Estimation)。
它的核心思想其实非常直觉:
如果模型一直往同一个方向走,就加快速度。
如果模型来回震荡,就减慢速度。
换句话说: Adam会自动调整学习率。如下图所示:
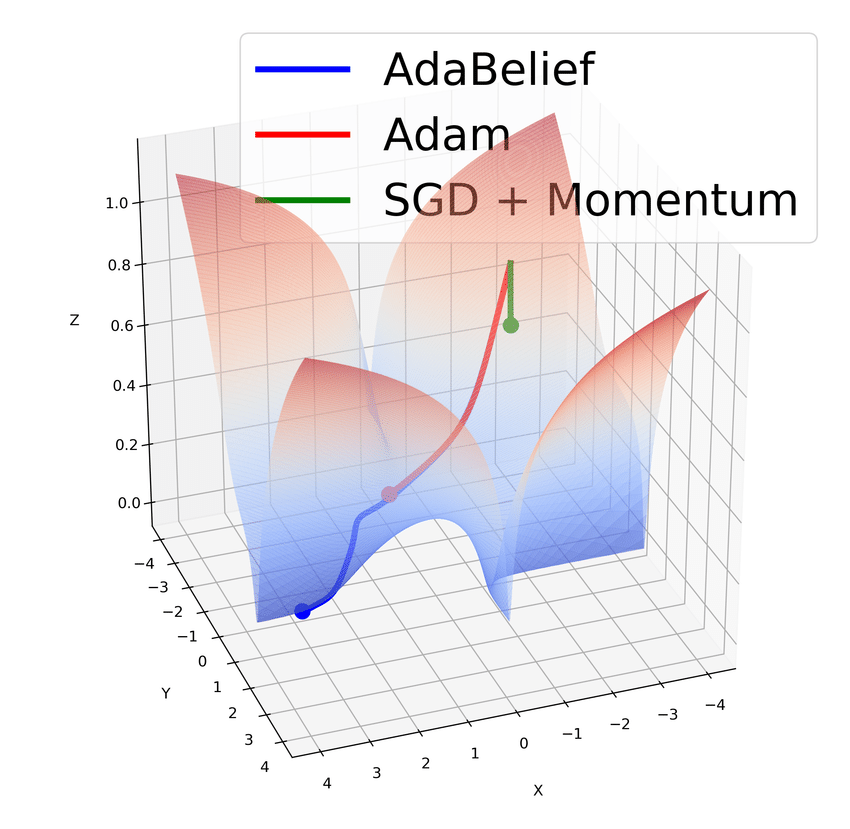
相比普通梯度下降一步一步走,Adam会根据训练情况动态调整:快一点、慢一点、换方向……因此模型往往可以更快收敛。
为什么Adam更强
Adam有一个非常重要的特性:它为每一个参数设置不同的学习率。
假设模型有1000个参数。
普通梯度下降:所有参数用同一个学习率
Adam:每个参数都有自己的学习率
这意味着:某些参数可以更新得更快,某些参数可以更新得更慢。
结果就是:整体训练速度大幅提升。
TensorFlow中使用Adam
在实际工程中使用Adam非常简单,只需要在编译模型时指定优化器:
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),
    loss="categorical_crossentropy"
)
这里的关键参数是learning_rate,通常设置为0.001,在大多数任务中都能取得不错的效果。
因此在实践中,Adam几乎已经成为神经网络训练的默认优化算法。
Dense层的局限
到目前为止,我们使用的神经网络层都是Dense Layer(全连接层)。意思是每一个神经元都会看到上一层的所有输入。
例如:
上一层100个神经元
下一层每个神经元都会读取这100个值
这种结构非常通用,但有一个问题:计算量很大。
而且在某些任务中,其实没有必要看全部信息。
卷积层:只看局部信息
在图像识别中,人类其实也是这样观察世界的。
当你看一张照片时,你不会同时分析整张图。而是先观察:局部边缘、局部形状、局部纹理。
卷积神经网络(CNN)正是基于这种思路。如下图所示:
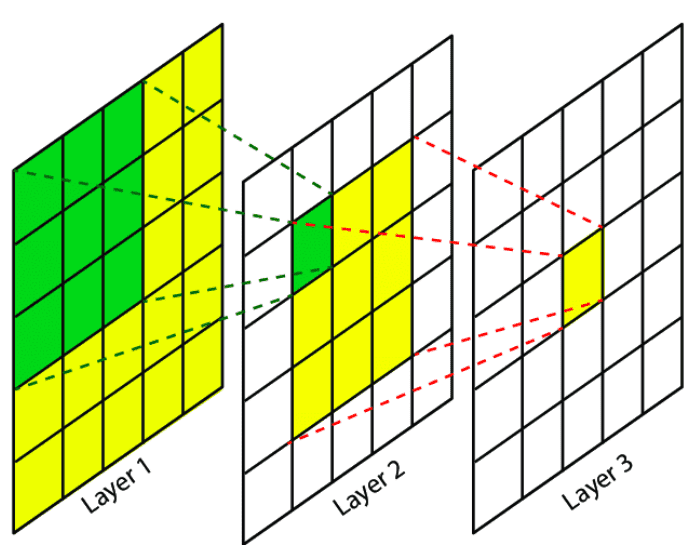
卷积层的特点是:每个神经元只看输入的一小块区域。
例如:
3×3 像素
5×5 像素
然后这个窗口会在整张图上滑动。这样做有几个好处:
1、计算更快——因为每个神经元只处理一小部分数据。
2、需要更少训练数据……模型更容易学习到局部特征。例如:边缘、角点和纹理等。
3、不容易过拟合——因为参数数量更少。
卷积网络的典型结构
一个典型的图像识别神经网络通常是这样:
输入图像
↓
卷积层
↓
卷积层
↓
全连接层
↓
分类输出
例如:
猫
狗
鸟
马
很多著名的AI系统都使用这种结构,例如:人脸识别、自动驾驶视觉系统和医学影像识别等。
神经网络的发展
如果回顾神经网络的发展,会发现一个非常有意思的规律。
研究者不断在做一件事情:发明新的网络层。
例如:
Dense Layer
Convolution Layer
LSTM
Transformer
Attention
……
每一种新的层结构,都让神经网络在某些任务上变得更强。
例如:
CNN → 图像识别
LSTM → 时序数据
Transformer → 自然语言处理
这些层就像神经网络的积木。
研究者通过组合不同的积木,构建出更复杂的AI系统。
在机器学习的发展过程中,两个方向一直在不断进化:一方面,是更高效的优化算法,例如Adam,让模型学习得更快。另一方面,是新的网络结构,例如卷积层,让模型能够更好地理解复杂数据。
这些看似细微的改进,实际上推动了整个深度学习领域的快速发展。
如果说早期的机器学习主要依赖数学模型,那么现代人工智能的进步,很大程度上来自于这样一种工程思想——通过不断设计新的结构和新的算法,让机器逐渐具备理解世界的能力。
而这,也正是深度学习不断演进的核心动力。
附录:本文涉及的专有名词中英文对照(标红为最核心)