CHAPTER 12 / 37
过度拟合:为什么模型越努力可能越出错?
过度拟合教会我们的,是模型真正的危险,不是学不会,而是学得太认真——直到把错误也当成了规律。
如果你已经跟着前面几篇一路走到这里,可能会产生一个很自然的误解:模型学得越复杂,效果应该越好。
但现实往往相反,很多时候,模型越“认真”,结果反而越差。
这就是今天要讲的主题——过度拟合(Overfitting)。
先从一个案例开始
假设你在做一个 App,需要预测:用户是否会在 7 天内流失。
你手里有一些数据:使用时长、打开次数、是否开启通知、页面停留时间……
于是你训练了一个模型。
第一版很简单,只用少量特征。
第二版,你加入大量组合特征:
使用时长²
使用时长 × 打开次数
打开次数³
各种复杂交叉关系
…
结果出现了一个非常诡异的现象:
在训练数据上:准确率接近100%
在预测真实用户上:效果明显下降
这不是模型变差了,而是模型学得太认真了导致出现了过度拟合的情况。
什么叫过度拟合?
模型不仅学会了规律,还学会了噪音。
我们先看模型的三种典型状态:
1、欠拟合(Underfitting)
模型太简单,看不到真正规律。
预测普遍不准,像一个只看表面的人。
2、正好(Just Right)
模型复杂度适中,抓住主要趋势,对新数据表现稳定。
这才是机器学习真正的目标。
3、过度拟合(Overfitting)
模型太复杂,记住了每一个训练样本,连偶然误差都当成规律。
结果就是:对过去特别了解,对未来毫无判断力。
用代码直观看到“过度拟合”
假设数据表示:用户使用时长 vs 留存率。
我们用不同复杂度的模型去拟:
import numpy as np
import matplotlib.pyplot as plt
# 模拟数据
np.random.seed(0)
x = np.linspace(0,10,20)
y = np.sin(x) + np.random.normal(0,0.2,len(x))
# 不同复杂度
coef1 = np.polyfit(x,y,1)
coef3 = np.polyfit(x,y,3)
coef10 = np.polyfit(x,y,10)
p1 = np.poly1d(coef1)
p3 = np.poly1d(coef3)
p10 = np.poly1d(coef10)
x_plot = np.linspace(0,10,200)
plt.scatter(x,y,label="data")
plt.plot(x_plot,p1(x_plot),label="Underfitting")
plt.plot(x_plot,p3(x_plot),label="Good Fit")
plt.plot(x_plot,p10(x_plot),label="Overfitting")
plt.legend()
plt.title("Underfitting vs Overfitting")
plt.show()
运行结果如下图:
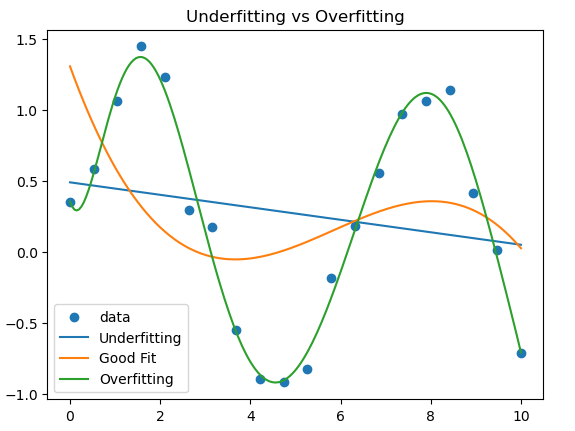
运行后你会看到:
-
直线:明显太简单(欠拟合)
-
三次曲线:趋势合理
-
十次曲线:疯狂扭曲
最后那条“疯狂扭动”的线,就是过度拟合。
它试图经过每一个点。但真实世界,从来不会这么整齐。
为什么过度拟合一定会发生?
核心原因只有一句:
模型自由度 > 数据提供的信息量。换成人话就是,数据只有 20 条,而模型却有几十个参数。
那模型唯一能做的,就是“背答案”。
一个很多人没意识到的真相
过度拟合并不是模型犯错。
它只是太努力满足训练数据。
从模型视角看,它其实做得很好。
问题在于:训练数据 ≠ 真实世界。
过度拟合在分类问题里更隐蔽
前面我们讲逻辑回归时,有一个概念叫:决策边界。
当模型过度拟合时,决策边界会变成:
-
极度弯曲
-
充满小拐点
-
完全围绕训练数据打转
这种模型看起来很聪明,但实际上一点点新数据就会让预测崩掉。
如何解决过度拟合的问题
经典方法有三种:
1、更多数据
这是最有效的方法。
更多数据会让模型无法记住每一个点,只能学习整体趋势。
2、减少特征
少一些复杂组合。
让模型没机会“钻空子”。
3、正则化(Regularization)
这是下一篇要重点讲的。
通俗讲就是,不阻止模型学习,但限制它“太激动”。
很多人以为,机器学习是在寻找最复杂的模型。其实恰恰相反,真正好的模型,是刚好足够解释数据,但不会多想一步。
走到这里你会发现,机器学习真正困难的地方,从来不是让模型学会。而是让模型学会“克制”。
模型可以很聪明,但真正优秀的模型,知道什么时候该停下来。
附录:本文涉及的专有名词中英文对照(标红为最核心)