CHAPTER 02 / 37
线性回归:一条直线是如何被训练出来的?
关于线性回归模型和成本函数的大白话介绍。
在上一篇里,我们讨论了监督学习和非监督学习的区别。本篇开始进入第一个具体模型:线性回归(Linear Regression)。
线性回归并不复杂,它只是试图回答一个问题: 如果输入变化一点,输出会怎样变化?
它的形式非常简单,但几乎所有更复杂的模型,都能在它身上找到影子。
理解它,相当于理解了“模型”和“成本函数”之间的关系。
从一个数据集开始
假设你在做一个知识付费产品。你统计了用户数据:
x:平均每日阅读时长(分钟)
y:未来7天的付费金额(元)
数据如下:
我们先把它画出来:
import numpy as np
import matplotlib.pyplot as plt
x = np.array([5,10,15,20,25])
y = np.array([20,45,60,85,110])
plt.scatter(x,y)
plt.xlabel("Daily Reading Time (min)")
plt.ylabel("7-Day Payment (¥)")
plt.title("Reading Time vs Payment")
plt.show()
在Jupyter Notebook中输入上述代码,生成示意图如下:
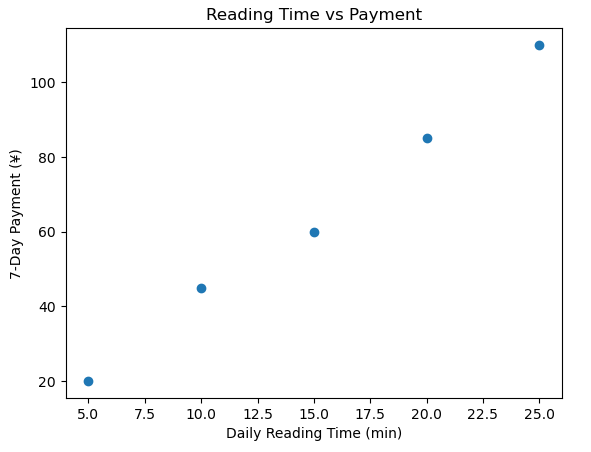
可以看到:数据大致呈上升趋势。
这时我们会自然地想:能不能画一条直线,去“概括”这组数据?
模型:一条可以移动的直线
线性回归模型形式是:
𝑓(𝑥) = 𝑤𝑥 + 𝑏
其中,
w:斜率(阅读增加1分钟,付费增加多少)
b:截距(阅读为0时的预测值)
不同的 w 和 b,会得到不同的直线。换句话说,训练模型,就是在调 w 和 b。比如:
w = 4
b = 0
y_pred = w*x + b
plt.scatter(x,y,label="Actual")
plt.plot(x,y_pred,color='red',label="Prediction")
plt.legend()
plt.show()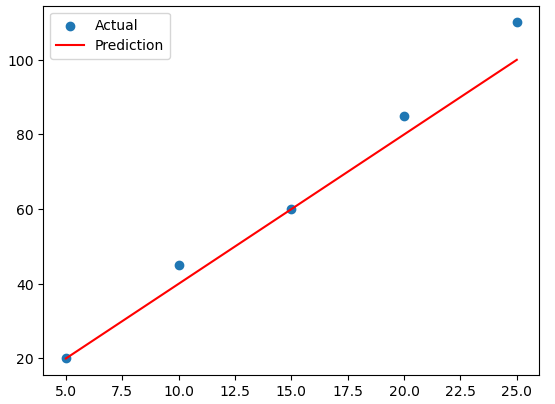
你可能会看到一条偏低的直线。
如果换一组参数:
w = 5
b = -5
直线会整体上移或变陡。
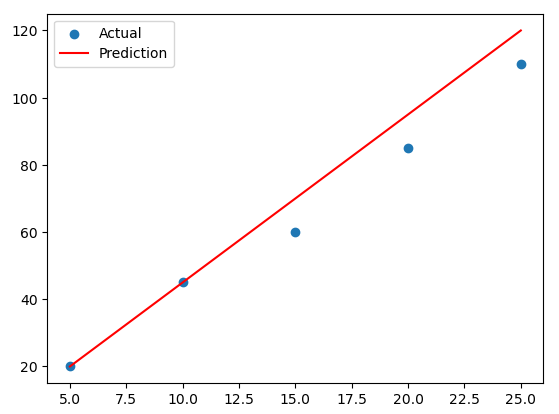
我们可以想象很多条可能的线,但问题是,哪一条线是“最好”的?
误差:每个点离直线有多远?
假设我们选定某条线,对于每个样本点:蓝点是真实值,直线上的点是预测值,它们之间的垂直距离,就是误差。如下图所示(该图来自互联网):
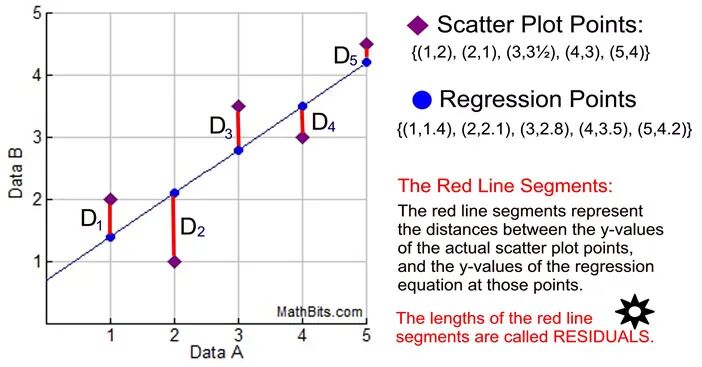
每个竖线,就是误差,
误差=预测值−真实值
如果误差为正,说明预测偏高。为负,说明预测偏低。
成本函数:把所有误差合在一起
我们不能只看一个点。我们要衡量:整条线整体表现如何?于是定义了成本函数,成本函数的公式如下:
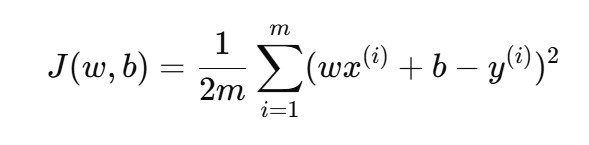
对于这个公式,具体怎么来的,可以问AI,解释一下:
-
每个点的误差平方
-
所有误差求平均
-
除以2是为了后续计算方便
代码如下:
def compute_cost(x,y,w,b):
    m = len(x)
    total = 0
    for i in range(m):
        prediction = w*x[i] + b
        total += (prediction - y[i])**2
    return total/(2*m)
现在我们可以比较不同直线的好坏。
成本函数长什么样?
先简化一下,假设b = 0,只改变 w。我们计算不同 w 对应的成本:
w_values = np.linspace(0,10,100)
costs = []
for w_val in w_values:
    costs.append(compute_cost(x,y,w_val,0))
plt.plot(w_values,costs)
plt.xlabel("w")
plt.ylabel("Cost J(w)")
plt.title("Cost vs w")
plt.show()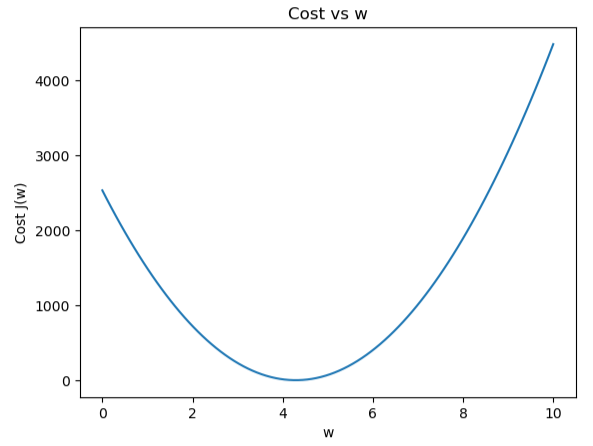
你会看到一个U形曲线。
最低点对应的 w,就是最优斜率。
当 w 和 b 同时变化时
此时成本函数变成三维:横轴为w,纵轴为b,而高度为J(w,b),它的形状像一个碗:
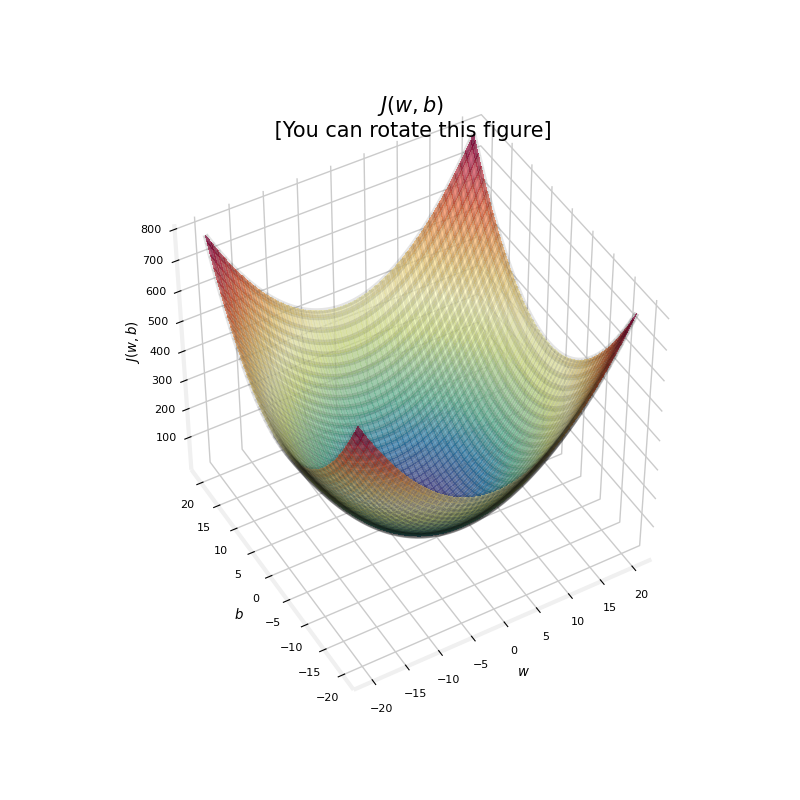
中心点,就是最佳参数。
为什么平方误差?
有一个很关键的点:成本函数为什么要平方?
因为平方带来一个重要性质:成本函数是凸的(convex)。
凸函数意味着:只有一个全局最小值,以及不会有多个局部最优。
这在优化时非常重要。
如果成本函数像一个碗,任何往下走的方向,最终都会到达最低点。
这就是后面“梯度下降(Gradient Descent)(下一篇会介绍)”可以有效工作的原因。
模型和成本函数的关系
到这里,我们可以总结结构:
-
模型:负责生成预测
-
成本函数:衡量预测偏差(负责给预测打分)
-
训练过程:找到使成本最小的参数
换句话说,模型负责表达,成本函数负责评价,优化算法负责寻找最优点。
线性回归只是最简单的一个例子。
但这种结构—— “定义模型 → 定义损失 → 最小化损失” 会贯穿整个机器学习。
这一篇其实只讲清楚了一件事:一条直线本身并不重要,重要的是它背后的结构——先假设一个模型,再用一个标准去衡量它,然后不断调整,直到误差最小。
本篇开始,公式看起来有点多,但它们只是把“试一试、看好不好、再改一改”这件事写得更精确。机器学习并不是突然变聪明的黑箱,它是一步一步被构造出来的。只有理解它是怎么被“训练”出来的,我们才会真正明白它是怎么在运行。
附录:本文涉及的专有名词中英文对照(标红为最核心)
A、线性回归
B、相关数学表达
C、优化相关