CHAPTER 04 / 37
多元线性回归与矢量化:机器是如何同时处理上百个特征的?
当模型从一个特征扩展到多个特征时,用多元线性回归进行预测,并通过矢量化让计算真正高效地运行起来。
在前三篇里,我们已经完成了一条完整的学习路径:
第一篇:机器学习在做什么
第二篇:线性回归与成本函数
第三篇:梯度下降如何找到最优解
到这里,一个很自然的问题出现了:真实世界的问题,几乎从来不是单变量。上一章我们只用了一个变量𝑥。 但现实里,一个结果往往由多个因素共同决定。
这一篇,我们正式进入多元线性回归(Multiple Linear Regression) 以及让算法真正高效运行的关键——矢量化(Vectorization)。
为什么单变量模型不够用了?
假设我们在做一个外卖平台配送时间预测模型。目标是预测一次订单的配送耗时(分钟)。
如果只用一个特征,例如,配送距离。模型可能是:𝑓 ( 𝑥 ) = 𝑤 𝑥 + 𝑏
但真实世界显然复杂得多:距离、是否高峰期、骑手密度、天气情况、商家出餐速度等,单一变量几乎不可能解释结果。
进入多元线性回归
于是,我们定义多个输入特征:
-
𝑥1:配送距离(km)
-
𝑥2:是否高峰期(0/1)
-
𝑥3:附近骑手数量
-
𝑥4:天气指数
模型变成:
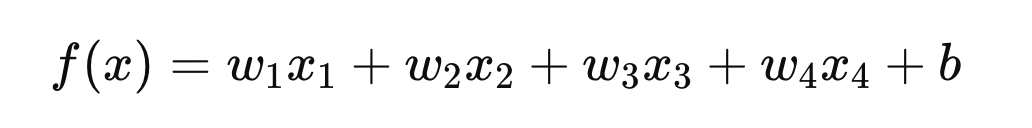
直觉上理解,
-
距离越远 → 时间越长
-
高峰期 → 时间增加
-
骑手越多 → 时间减少
每个参数𝑤𝑗,本质上就是:某个因素对结果的影响权重。
从“多个数字”到“向量”
当特征越来越多时,一个问题出现:如果有 100 个特征怎么办? 难道要写:
w1*x1 + w2*x2 + w3*x3 + ...显然不现实。
于是数学做了一件非常优雅的事情:把一组数字,看成一个整体,即通过向量表示:
我们定义:
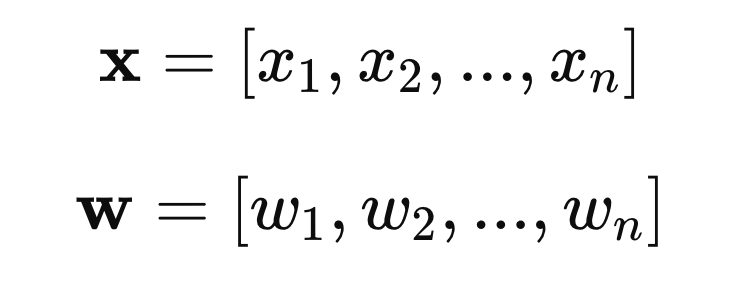
模型可以写成:𝑓 ( 𝑥 ) = 𝑤 ⋅ 𝑥 + 𝑏
这里的 “·” 是点积(dot product),它本质上就是:
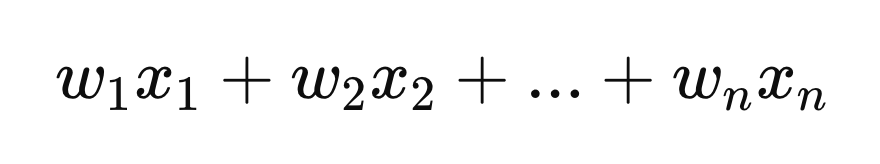
只是写法更简洁。
矢量化:让算法真正变快的关键
到目前为止,我们只是把模型从一个变量扩展到了多个变量。但新的问题马上出现:当特征很多时,计算量会急剧上升。
假设我们有:100个特征和10万条训练数据,如果仍然使用最直观的写法:
f = 0
for j in range(n):
    f += w[j] * x[j]
看起来没有问题,但它有一个致命缺陷:计算是逐步执行的。
也就是说:第一步算完才能算第二步,第二步算完才能算第三步,这种方式叫串行计算(Serial Computation)。
当数据规模变大时,速度会迅速下降。因此,我们需要通过矢量化来解决这个问题。
什么是矢量化(Vectorization)?
矢量化的核心思想其实非常简单:不再一个一个计算,而是把一整组计算同时完成。
我们先回忆模型:
传统方式是:逐个乘,逐个加。
而矢量化的思路是:把 𝑤 和 𝑥 看成整体,一次完成所有乘法和加法,写成数学形式: 𝑓 ( 𝑥 ) = 𝑤 ⋅ 𝑥 + 𝑏 ,对应代码只有一行:
f = np.dot(w, x) + b为什么矢量化会快很多?
很多人第一次看到这里,会以为只是写法更简洁。
但真正的关键在于,矢量化不仅是代码优化,而是计算方式的改变。
1、CPU的真实工作方式 :
现代CPU并不是只能一次做一个运算。 它内部有:
-
SIMD指令集(Single Instruction Multiple Data)
-
向量寄存器
-
并行计算单元
意思是,一条指令,可以同时处理多个数字。
如果你用for循环,CPU只能一步一步执行。而使用矢量化后,CPU可以同时读取整段内存,同时完成多次乘法以及,同时完成加法累积
2、GPU的优势更加明显:
GPU原本是为了图形渲染设计的。图形计算的特点是:同时处理大量像素,这与向量运算高度一致。
所以当代码是矢量化时,GPU可以一次处理上千个运算。这也是为什么几乎所有深度学习框架,本质都是在做大规模矢量化计算。
3、一个直观对比:
可以这样理解:
非矢量化:一个工人搬100箱货,一次搬一箱。
矢量化:100 个工人同时搬。
算法没变,但效率发生数量级变化。
矢量化不仅是预测,更是训练
前面我们在梯度下降中更新参数:
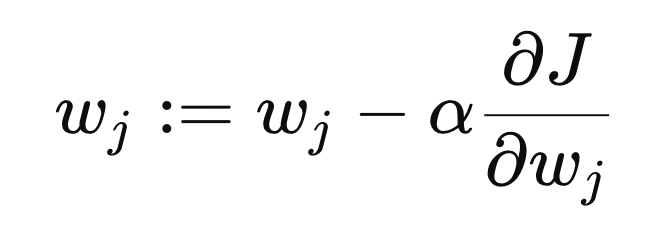
如果参数很多:
普通写法:
for j in range(n):
    w[j] = w[j] - alpha * grad[j]
矢量化写法:
w = w - alpha * grad注意这里发生的事情:
-
所有参数同时更新
-
所有梯度同时参与计算
这不仅让代码更短,更重要的是:每一次迭代都能最大化利用硬件算力。
为什么机器学习离不开矢量化?
到这里可以总结一个非常关键的事实:机器学习之所以在过去十年爆发,很大一部分原因不是算法突然变聪明,而是我们终于学会让算法充分利用现代硬件。
矢量化带来的结果是:
-
更快的训练速度
-
更大的模型规模
-
更高的数据吞吐量
没有矢量化,深度学习几乎不可能落地。
真正的升级:从“算公式”到“驾驭计算结构”
这一篇看起来只是:从一个特征变成多个特征,从for循环变成 np.dot
但真正发生的变化不是语法,而是思维方式。
你开始意识到:模型不是一堆公式,而是一种计算结构。
当特征变成向量,当参数更新变成矩阵运算,算法开始脱离“手算逻辑”,进入“机器逻辑”。
多元线性回归解决的是世界是多维的,矢量化解决的是机器是并行的。
当这两件事结合起来,机器学习才真正具备规模化能力。
这一步,是从“理解模型”走向“理解计算”的关键转折。
当特征数量从1个变成100个,真正改变的并不是公式,而是计算方式。矢量化让模型不再逐步计算,而是一次性并行处理整组数据,充分利用CPU与GPU的并行能力。
这种效率提升,并不是“写法更优雅”,而是数量级的性能差异——也是现代机器学习能够处理海量数据的前提。
回到模型本身,多元线性回归不过是把世界拆成多个维度,再用一条高维空间中的超平面去逼近规律。而矢量化,则是让这种数学结构真正落地运行。一个解决表达能力,一个解决计算效率,两者缺一不可。
当你理解这一层逻辑,你会发现,机器学习真正强大的地方,并不在某个复杂公式,而在于它如何把数学结构转化为可规模化的计算系统。模型开始变得不只是“聪明”,而是“高效”。而这,才是智能走向现实世界的关键一步。
附录:本文涉及的专有名词中英文对照(标红为最核心)