CHAPTER 15 / 37
神经网络模型:它在内部到底做了什么?
神经网络模型,不过是层层函数的叠加。
在上一篇文章里,我们理解了神经网络本质上是一个“自动学习特征表示”的系统,但那更像是宏观视角。
这一篇,我们进入模型内部。不是去推导复杂数学,而是回答一个更实际的问题:神经网络在计算时,到底在算什么?这一篇的目标只有一个:让你真正知道——模型从输入到输出,中间发生了什么。
从最小单元开始:一个神经元在做什么?
假设你在做一个电商推荐系统,要判断:某个商品是否值得推荐给用户?
输入信息包括:用户最近浏览次数、商品价格、商品评分、是否有折扣等。
如果我们只用一个“神经元” ,它其实就是在做这件事:
把所有输入加权求和 → 再经过一个非线性函数 → 输出一个结果结构如下图所示:
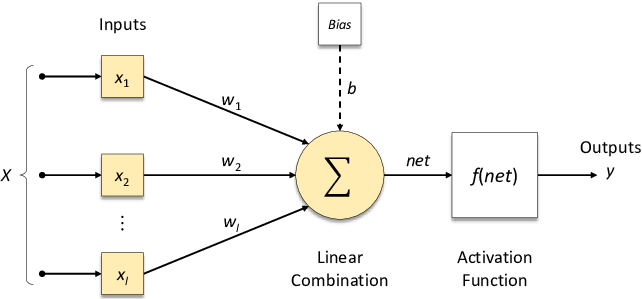
可以用一句话描述:神经元 = 加权求和 + 激活函数
为什么这看起来很熟? 因为:
没有激活函数,它就是线性回归。加上Sigmoid ,它就是逻辑回归。也就是说: 一个神经元,本质上就是我们之前学过的模型。
神经网络并不是凭空出现的新东西,它是把“很多个逻辑回归单元”叠在一起。
一层神经元到底在做什么?
假设我们有4个输入特征,第一层里有3个神经元。会发生什么?
每一个神经元都会:
看到全部输入
用自己的一组参数去计算
输出一个数
比如:
神经元1:更关注价格
神经元2:更关注评分
神经元3:更关注折扣和浏览行为
最终输出一个向量:[0.3, 0.7, 0.2] ,这3个数字就是这一层的输出。
我们把它叫做:激活值(Activation)。
两层神经网络是怎么工作的?
一层神经网络,其实就是多个神经元并行计算。
可以想象成一个小团队:
每个人看同一份数据
每个人得出不同的判断
汇总成一个新的信息向量
这就是隐藏层的作用。
现在我们加一层。
第一层输出:[0.3, 0.7, 0.2]
第二层再对这三个数做一次加权组合。 结构如下:
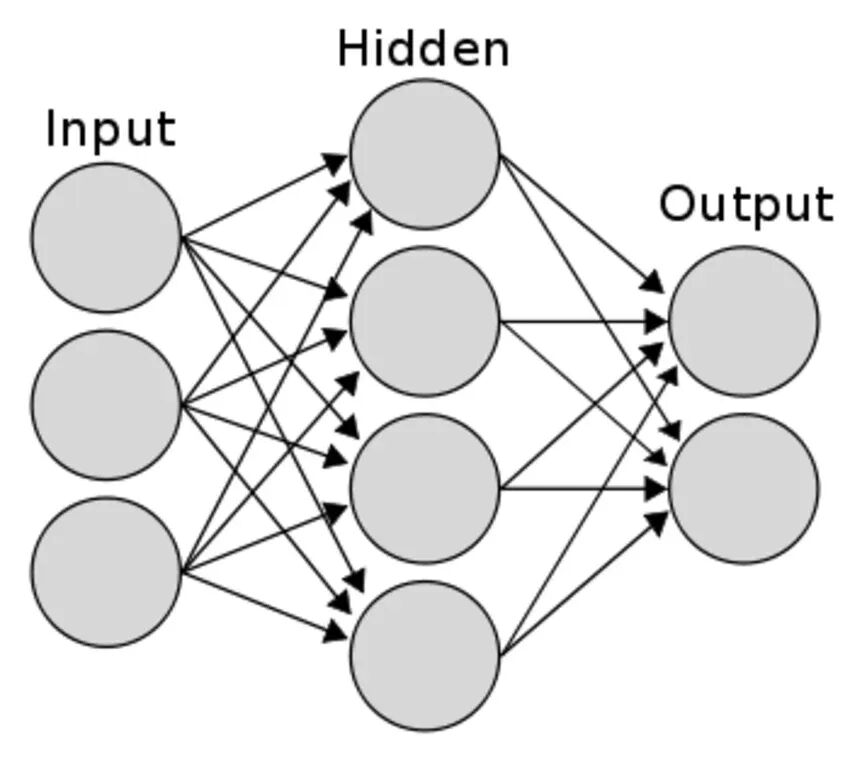
第二层可能会学到:
综合价值判断
用户兴趣匹配度
最后输出: 0.84,代表:有84%的概率值得推荐。
前向传播
从输入开始:
计算第一层输出
把结果传给第二层
再算一遍
最终得到预测结果
这个从左到右的计算过程叫:前向传播(Forward Propagation)。
它只是一个顺序计算过程,只是层层函数叠加。
为什么一定要有“激活函数”?
这是很多人忽略的关键点。
如果每一层都只是线性加权求和,那么无论堆多少层,结果还是一个线性模型。
换句话说,没有激活函数,神经网络不会变强。
激活函数(例如 Sigmoid、ReLU) 引入了“非线性”,这才让模型能够学习复杂关系。
多层网络到底强在哪里?
想象一下这个抽象过程:
第一层:学习基础信号
第二层:学习组合关系
第三层:形成更高层次概念
这就像:
像素 → 边缘
边缘 → 形状
形状 → 物体
层数越多,抽象越深,这也是“深度学习”真正的含义。
如果站在产品角度,神经网络模型做的事情可以简化为:
输入数据 → 多次结构化重组 → 输出决策区别在于:过去是人定义结构,现在是模型自己寻找结构。
但模型内部依然是:
加权
组合
非线性变换
只是有很大的规模。
这一篇你需要真正记住的只有三句话:
-
一个神经元 = 线性模型 + 激活函数
-
一层 = 多个神经元并行
-
神经网络 = 多层函数的堆叠
神经网络并没有什么特别,它是函数的叠加。
但当函数足够多、层数足够深时, 机器就能学会越来越抽象的表达方式。
真正的突破不在于“复杂”,而在于“结构”。当结构可以被不断堆叠,表达能力就被不断放大。模型从简单拟合,走向抽象建模,这一步,才是深度学习真正的起点。
附录:本文涉及的专有名词中英文对照(标红为最核心)