CHAPTER 22 / 37
模型评估:机器学习为什么需要三套数据?
本文介绍了如何通过训练集、验证集和测试集来评估机器学习模型,并用数据而非直觉判断模型是否真正有效。
在前面的文章中,我们已经学习了很多机器学习模型:线性回归、逻辑回归、神经网络、深度学习模型等,这些模型都能通过训练数据学习规律。
但有一个问题非常关键:如何判断一个模型是否真的好?
很多初学者都会犯一个非常常见的错误:模型在训练数据上表现很好,于是就认为模型很好。但现实往往不是这样。
机器学习中最经典的一个问题是:模型在训练数据上表现很好,但在真实世界数据上表现很差。
因此,在机器学习项目中,一个非常重要的能力是:评估模型。
一个真实世界的例子
假设你在做一个音乐推荐系统,你的目标是预测用户是否会点击一首推荐歌曲。
你训练了一个模型,并且在训练数据上测试:准确率98%。
听起来非常不错。但当模型上线后,发现真实点击率预测只有:55%。
为什么会出现这种情况?
原因往往是:模型只记住了训练数据而不是学会了真正的规律。
训练数据不是全部
假设我们有1000条用户行为记录的历史数据。
如果我们用全部数据训练模型,然后再用这些数据测试模型,模型当然会表现很好——因为模型已经见过这些数据。
这就像考试前把答案背下来,考试时当然会得高分。
但如果换一套新题,成绩可能很差。
这就是机器学习中的核心问题:泛化能力(Generalization)。
也就是模型在新数据上的表现。
训练集与测试集
解决这个问题的方法其实非常简单:把数据拆开。 示意结构如图所示:
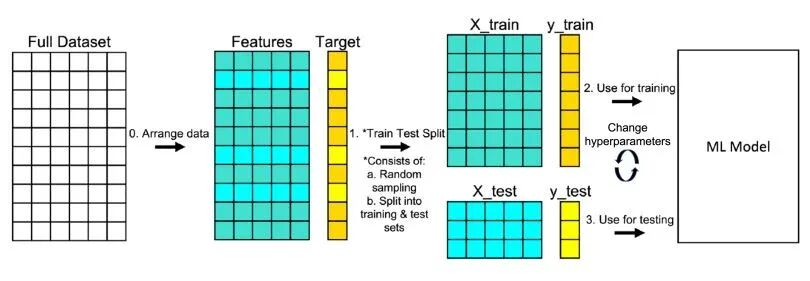
假设我们有:
1000 条数据可以拆分为:
训练集(Training Set) 80%
测试集(Test Set) 20%
流程变成:
训练模型 → 用测试集评估这样测试数据是模型没有见过的,因此测试结果更接近真实表现。
如何评估模型表现
评估方法取决于任务类型。
1、回归问题
例如:
预测商品销量
预测房租
预测温度
常见指标是:
平均误差(Mean Squared Error)简单理解就是:预测值和真实值的差距——误差越小模型越好。
2、分类问题
例如:
垃圾邮件识别
用户是否会点击广告
图片识别
最常用指标是:
准确率(Accuracy)例如:
测试集200条数据
预测正确180条
那么:准确率 = 90%,评估方法取决于任务类型。
TensorFlow中的简单评估
在实际项目中,评估模型通常非常简单。
例如:
model.evaluate(X_test, y_test)框架会自动计算:
loss
accuracy
这样就可以快速了解模型在新数据上的表现。
为什么还不够?
很多人会认为训练集 + 测试集已经足够。
但实际工程中还会遇到一个问题:模型选择。
例如你有三个模型:
模型A:简单模型
模型B:中等复杂度
模型C:非常复杂
哪个更好? 如果直接用测试集选择,测试集就被“用掉了” ,这样测试结果会变得不可靠。
引入第三个数据集
解决方法是:增加一个新的数据集。示意结构如图所示:
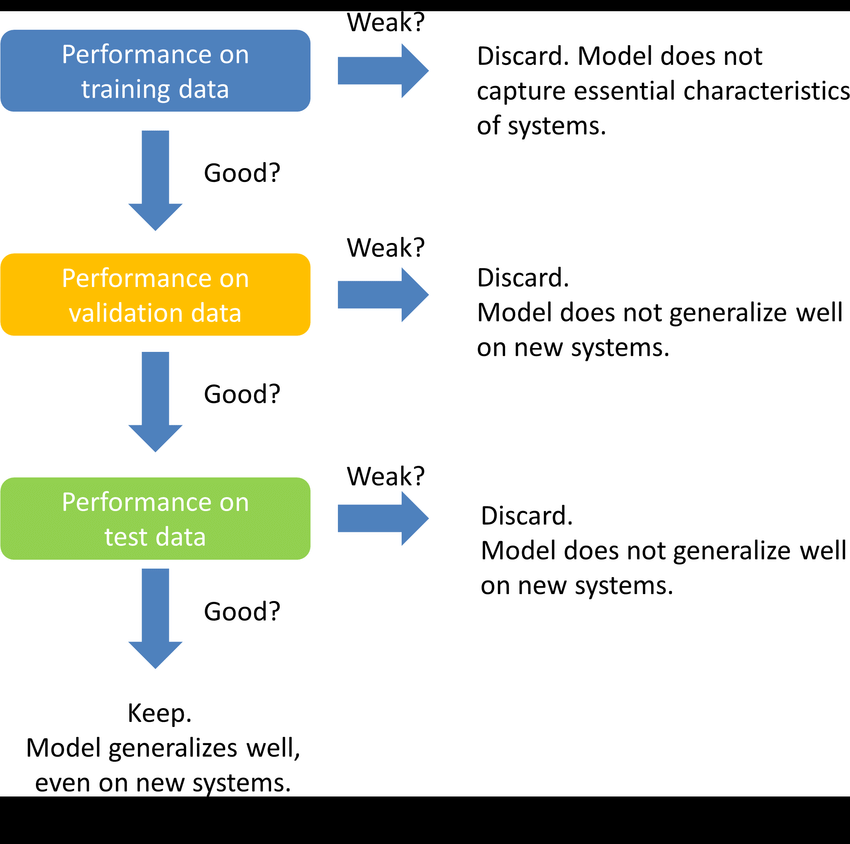
数据会被分成:
训练集(Training Set)
验证集(Validation Set)
测试集(Test Set)
例如:训练集60%,验证集20% ,测试集20%。
三个数据集的分工角色不同:
训练集:训练模型参数
验证集:选择模型、调节参数
测试集:最终评估模型
流程变成:
训练模型
 ↓
验证集选择模型
 ↓
测试集最终评估
假设你训练了三个神经网络:
模型A: 2层神经网络
模型B: 4层神经网络
模型C: 8层神经网络
在验证集上的表现:
A:85%
B:92%
C:88%
那么:选择模型B
然后再用测试集评估:
最终准确率 = 91%这才是模型真实表现。
机器学习项目的核心能力
很多机器学习项目失败,并不是因为算法不够先进,而是因为团队没有建立正确的流程。
一个成熟的机器学习流程通常是:
数据准备
 ↓
训练模型
 ↓
验证模型
 ↓
选择模型
 ↓
最终测试
通过不断循环这个过程,模型会逐渐变好。
通过合理地划分训练集、验证集和测试集,我们可以避免很多常见陷阱,例如:过拟合、错误的模型选择、过于乐观的评估结果等。也正因为如此,模型评估不仅仅是一个技术细节。它其实决定了一个机器学习项目能否真正落地。
换句话说,机器学习不仅是训练模型,更是不断验证模型。从更宏观的角度来看,机器学习并不仅仅是训练模型的过程,它更像是一种不断提出假设、验证假设、再修正假设的循环。
模型评估正是这个循环中的关键环节,它让我们能够用数据而不是直觉来判断下一步应该做什么。也正因为如此,一个成熟的机器学习团队往往并不是拥有最复杂的算法,而是拥有一套清晰、稳定且可重复的评估流程。当评估机制建立起来之后,模型的改进就不再依赖运气,而会逐渐变成一种可以持续优化的工程能力。
附录:本文涉及的专有名词中英文对照(标红为最核心)