CHAPTER 08 / 37
特征工程与多项式回归:线性模型为什么能拟合曲线?
机器学习不仅是选择模型,更是通过特征与流程设计,让模型更容易理解数据。
上一节我们讲了梯度下降如何更快、更稳定地找到答案。
但一个真正关键的问题还没解决: 如果数据本身不是直线关系怎么办?
现实世界中,大多数关系都不是线性的。
今天这一篇,我们要迈出一个非常关键的台阶:让线性回归,学会拟合曲线。
而这一步的核心,就是特征工程(Feature Engineering)、多项式回归(Polynomial Regression)和Scikit-Learn工程实现。
为什么“选对特征”比算法更重要?
很多人刚学机器学习时,会以为算法决定一切。但真实工程里,经常是:模型很普通,但特征设计非常聪明。
假设你要预测一家咖啡店每天卖出的咖啡数量,已有特征如下:
x₁:当天气温(℃)
x₂:降雨量(mm)
你可能先写出模型:𝑓(𝑥) = 𝑤1𝑥1 + 𝑤2𝑥2 + 𝑏
但现实是:温度太低 → 人少;温度适中 → 人多;温度太高 → 人又少。
这显然不是一条直线。
于是问题来了,如果真实关系是弯曲的,是否可以通过改变特征,让线性模型也能学习曲线?这正是特征工程要解决的问题。
什么是特征工程(Feature Engineering)?
一句话解释特征工程是:利用你对问题的理解,主动创造新的特征。
例如,假设我们觉得22℃最舒适,那么可以构造:
comfort = -(temperature - 22)**2新的模型则变为:
𝑓 ( 𝑥 ) = 𝑤1𝑥1 + 𝑤2𝑥2 + 𝑤3𝑥3 + 𝑏
其中:x₃ = comfort。通过创造一个新的特征,让模型更好地拟合真实场景。
我们没有换算法,只是换了一种表达数据的方式。
多项式回归:让线性模型学会弯曲
很多人的误解是,多项式回归是新算法,其实不是。
多项式回归仍然是线性回归。区别只是对输入做了非线性变换。
假设真实关系是𝑦 = 𝑥**2(x的平方),这意味着普通线性模型 𝑦 = 𝑤𝑥 + 𝑏 无论怎么训练都无法拟合。
如果新增一个特征:x2 = x**2,则模型变成:
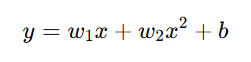
需要注意的是,参数仍然是线性的,只是特征变了。
多项式回归不是让模型更复杂,而是让输入空间更聪明。
接下来,我们直接用Python看它如何发生。
Python实现:多项式特征
假设我们需要预测一天中不同时间的共享单车使用量。
生成模拟数据如下:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
np.random.seed(42)
# 一天24小时
x = np.arange(0, 24, 1)
# 模拟一个非线性规律(早晚高峰)
y = 50 + 10*np.sin(x/3) + np.random.randn(len(x))*2
X = x.reshape(-1, 1)
1、普通线性回归
linear_model = LinearRegression()
linear_model.fit(X, y)
y_linear = linear_model.predict(X)
结果通常不理想。
2、多项式回归(核心)
poly = PolynomialFeatures(degree=3)
X_poly = poly.fit_transform(X)
poly_model = LinearRegression()
poly_model.fit(X_poly, y)
y_poly = poly_model.predict(X_poly)
3、使用matplotlib可视化
plt.figure(figsize=(9,5), dpi=120)
# 原始数据
plt.scatter(x, y, color='red', label='Actual Data')
# 线性回归结果
plt.plot(x, y_linear, label='Linear Regression')
# 多项式回归结果
plt.plot(x, y_poly, label='Polynomial Regression (degree=3)')
plt.xlabel("Hour of Day")
plt.ylabel("Bike Usage")
plt.title("Linear vs Polynomial Regression")
plt.legend()
plt.show()
运行后如图所示:
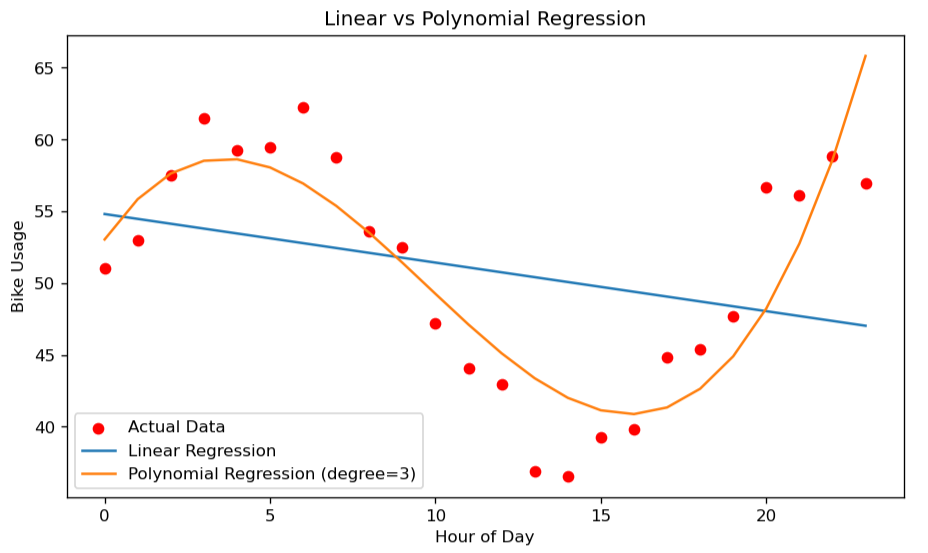
但新的问题来了,当我们加入高阶特征时:不同特征的数值范围会急剧扩大,这会直接影响梯度下降。
所以我们必须再次回到功能缩放(Feature Scaling)。
Scikit-Learn:工程中的标准工具
前面我们手写了多项式特征和线性回归。但在真实工程中,几乎没有人会从零实现所有算法。这时候一个名字一定会出现:Scikit-Learn。
Scikit-learn是Python生态中最重要的机器学习库之一。官方定位非常明确:Python中的机器学习工具集。
它的核心特点:简单高效的预测分析工具、基于NumPy/SciPy/matplotlib构建,以及开源。
可以通过https://scikit-learn.org/stable/查看官方文档。
为什么几乎所有公司都用它?
因为它解决了一个核心问题:统一的工程接口。
几乎所有模型都遵循同一套API:
model.fit(X, y)       # 训练
model.predict(X)      # 预测
model.score(X, y)     # 评估
无论你换:线性回归、决策树、随机森林还是SVM,代码结构几乎不变。
这意味着你在学习的是“机器学习接口”,而不是某一个算法。
这就是工程化。
Scikit-Learn 的核心功能模块
这里只是简单介绍下,详细的还是建议阅读官方文档。
很多人第一次用会觉得好像只是一个模型库,其实它覆盖了完整机器学习流程。
1、数据预处理(Preprocessing)
例如我们前面做的Feature Scaling:
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_norm = scaler.fit_transform(X)
这一步: 把实验代码变成工程流程。
2、特征工程(Feature Engineering)
比如我们刚刚用到的:
from sklearn.preprocessing import PolynomialFeatures它自动生成: x → [1, x, x², x³ …]
3、模型训练(Estimator)
例如:
from sklearn.linear_model import SGDRegressor
model = SGDRegressor()
model.fit(X, y)
SGDRegressor本质就是用梯度下降训练线性模型。
4、模型评估(Evaluation)
from sklearn.metrics import mean_squared_error真实工程中:训练 ≠ 结束,评估才是核心。
5、Pipeline
这是很多人容易忽视的,但工程里极其重要。
from sklearn.pipeline import Pipeline可以把流程串起来且一次完成: 缩放 → 特征工程 → 模型训练。
前面我们通过特征工程,让线性模型学会拟合曲线。
而Scikit-Learn的意义在于:把这些数学步骤,变成可复用的工程模块。
这到这里,我们其实做了一件很有意思的事情:并没有更换模型,却通过重新设计特征,让线性回归拥有了拟合曲线的能力。
从特征工程到多项式回归,再到Scikit-Learn的工程实践,这篇文章想表达的核心并不是某一个技巧,而是一种思路——很多时候,模型的上限并不取决于算法本身,而取决于我们如何理解问题、如何表达数据。
当你开始意识到特征本身就是建模的一部分时,机器学习的视角也会发生变化。
你不再只是调用一个模型,而是在主动决定模型看到的世界是什么样子。这种能力,往往比记住多少 API 更重要。
附录:本文涉及的专有名词中英文对照(标红为最核心)