CHAPTER 10 / 37
逻辑回归的成本函数:为什么不能使用平方误差?
逻辑回归的成本函数,本质是在惩罚“自信的错误”,而不是简单计算预测距离。
在前面的文章里,我们已经聊过什么是逻辑回归、为什么它用于分类问题以及,为什么输出是一个概率。
也讨论过成本函数与梯度下降的作用。
所以这一篇,不再解释“什么是成本函数”,而是聚焦一个很多人第一次学机器学习都会困惑的问题:既然平方误差在回归里很好用,为什么逻辑回归不用它?
这不是一个数学细节,而是逻辑回归能否稳定工作的核心。
一个看起来“理所当然”的错误
先从一个直觉开始。
假设我们要做一个分类任务:预测用户是否会在 7 天内续费会员。
y = 1 → 会续费
y = 0 → 不会续费
模型输出的是一个概率:
f(x) = sigmoid(wx + b)比如:
如果你之前学过线性回归,你的第一反应一定是:那就用平方误差。
即: (𝑓(𝑥) − 𝑦)2
看起来非常合理:
预测越接近真实值 → 误差越小
差距越大 → 误差越大
问题是: 逻辑回归 + 平方误差,会让优化过程变得非常难训练。
真正的问题:曲面变“坑坑洼洼”
逻辑回归里:
f(x) = sigmoid(wx + b)Sigmoid本身是一个非线性函数。
当你把平方误差套进去,整个成本函数会变成:不再是光滑的碗形,可能出现多个局部低点,从而导致梯度下降容易卡住。
简单说就是模型不知道往哪走。
这就像线性回归是在一个大碗里滚小球,而逻辑回归+平方误差是在一堆坑里乱滚。
逻辑回归真正使用的损失函数
逻辑回归选择了一种非常特别的设计。
它不是一个统一曲线,而是两种情况:
当 y = 1 时,损失定义为:−log(𝑓(𝑥))
意味着:
如果模型预测接近 1 → 损失接近 0
如果模型预测很小 → 惩罚巨大
当 y = 0 时,损失变成:−log(1−𝑓(𝑥))
跟y=1时情况相反:
预测接近 0 → 几乎没损失
预测接近 1 → 惩罚爆炸
逻辑回归在表达一个态度:可以不确定,但不能自信地错。
这是平方误差做不到的。
为什么要用 Log?
我们直接画图看一下。
通过运行下面的代码:
import numpy as np
import matplotlib.pyplot as plt
p = np.linspace(0.001, 0.999, 500)
loss_y1 = -np.log(p)
loss_y0 = -np.log(1 - p)
plt.figure(figsize=(7,4))
plt.plot(p, loss_y1, label="Loss when y=1")
plt.plot(p, loss_y0, label="Loss when y=0")
plt.xlabel("Model prediction probability f(x)")
plt.ylabel("Loss")
plt.title("Logistic Regression Log Loss")
plt.legend()
plt.grid(alpha=0.3)
plt.show()
可以得到如下的图像:
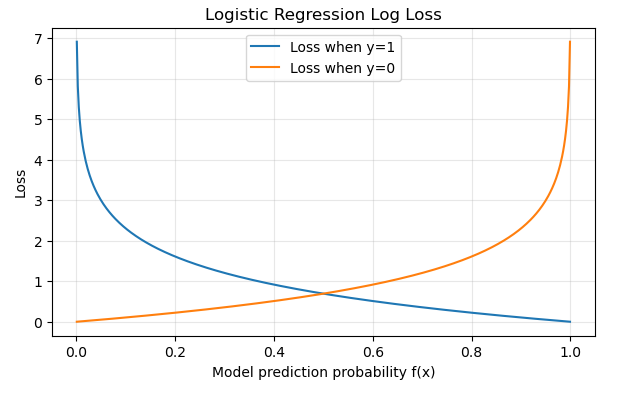
你会看到两条镜像曲线,
正确方向 → 平缓下降
错误方向 → 急剧上升
这意味着:模型会被强烈推动远离“自信的错误”。
一个容易理解的例子
假设你在做推荐系统,模型预测如下:
哪一个错误更严重? 显然是A。
因为系统“非常自信”地推荐错了。
Log Loss的设计就是:
普通错误 → 小惩罚
自信错误 → 巨大惩罚
这使模型更稳健。
把两种情况合成一个公式
虽然前面分两种情况写,但工程里用统一表达:
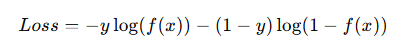
为什么可以? 因为当 y=1 时,第二项自动消失;而当 y=0 时,第一项自动消失,这就可以让一个公式覆盖全部情况。
完整的逻辑回归成本函数
对所有样本取平均,最终的逻辑回归成本函数如下:
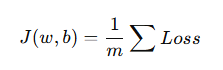
这也是逻辑回归的真正优化目标。
因为这个成本函数曲面是凸的,意味着梯度下降稳定,从而不容易陷入局部最优。
为什么这其实是统计学的选择?
要解释成本函数比较负责,这里简单来说。
这个成本函数不是拍脑袋发明的它来自:最大似然估计(Maximum Likelihood Estimation)。
含义是:找到一组参数,让真实数据出现的概率最大。
换句话说:逻辑回归不是在“拟合数值”,而是在最大化预测正确的概率。
用Python看看真实效果
下面是一个极简示意:
import numpy as np
import matplotlib.pyplot as plt
# 预测概率
p = np.linspace(0.001, 0.999, 500)
# Logistic Loss
log_loss_y1 = -np.log(p)
log_loss_y0 = -np.log(1 - p)
# Squared Error (对比用)
mse_y1 = (1 - p)**2
mse_y0 = (p)**2
plt.figure(figsize=(8,5))
plt.plot(p, log_loss_y1, label="Log Loss (y=1)", linewidth=2)
plt.plot(p, log_loss_y0, label="Log Loss (y=0)", linewidth=2)
plt.plot(p, mse_y1, "--", label="Squared Error (y=1)")
plt.plot(p, mse_y0, "--", label="Squared Error (y=0)")
plt.xlabel("Model prediction probability p")
plt.ylabel("Loss")
plt.title("Log Loss vs Squared Error")
plt.legend()
plt.grid(alpha=0.3)
plt.show()
生成图像如下:
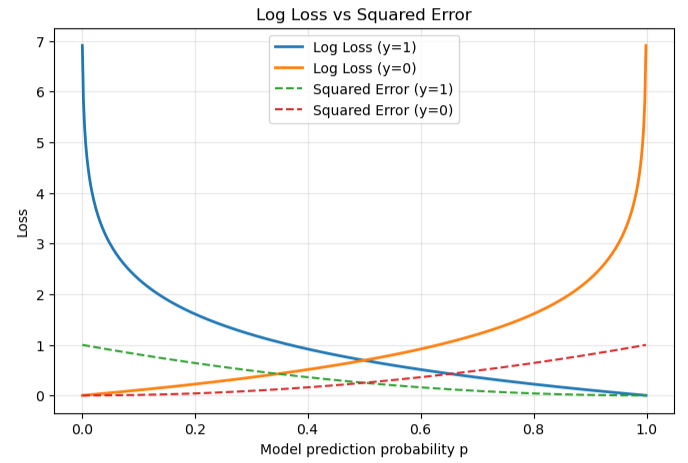
逻辑回归真正优化的是:让正确类别的概率越来越接近1。
这一篇,我们从一个简单的问题出发:为什么逻辑回归不能直接使用平方误差。沿着这个问题,我们看到了损失函数如何影响整个优化过程,也理解了为什么 log 形式的损失能够让模型稳定、可靠地学习出合理的决策边界。
当我们从回归走向分类时,模型的思维方式发生了变化:不再追求预测值接近目标,而是追求概率判断的可信度。
很多时候,算法的核心并不在于模型结构本身,而在于它被要求优化什么目标。模型只是工具,而成本函数决定了它努力的方向。
附录:本文涉及的专有名词中英文对照(标红为最核心)