CHAPTER 13 / 37
正则化:如何通过约束参数避免过度拟合?
正则化,我们终于学会如何让模型保持克制。
前一篇我们讲到一个很现实的问题:模型并不是学得越多越好。
当模型开始“记住”训练数据,而不是理解数据规律时,就出现了过度拟合(Overfitting)。
这一篇,我们不再停留在现象层面,而是进入真正的解决方案——正则化(Regularization)。
它不是一个新的模型,也不是新的算法,而是一种非常朴素但极其有效的思想:让模型在学习数据的同时,被适度约束。
为什么要“约束”模型?
假设你在做一个产品增长预测模型,输入特征有几十个:投放预算、渠道数、活动频率、用户等级、地区、节假日等等,而训练数据只有几百条。
这时候模型很容易出现一种情况:在历史数据上表现几乎完美;一上线,预测效果迅速变差。原因并不是模型不够聪明,而是它太努力地解释每一个历史细节了。
模型会通过不断放大某些参数,把训练数据里的噪声也当成规律。结果就是曲线越来越复杂,决策边界越来越扭曲,泛化能力下降——这就是过度拟合。
而通过约束模型,则可以减少这种情况的发生。
正则化的核心直觉:让模型“别太激动”
想象一下下面两种模型:
模型 A(没有约束)
-
参数可以无限变大
-
曲线可以任意弯曲
-
完美穿过所有训练点
模型 B(被约束)
-
参数不能太大
-
曲线更平滑
-
不追求完美贴合
现实中,模型 B 往往更可靠。
因为参数越大,模型越复杂。而复杂模型,更容易对数据中的偶然性产生反应。
所以正则化的核心思想就是:通过限制参数大小,让模型保持克制。
正则化成本函数
我们直接看公式。
1、线性回归的原始成本函数
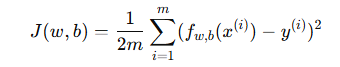
这是我们之前熟悉的均方误差。
2、加入正则化后的成本函数
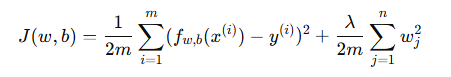
重点在第二项:
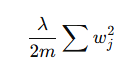
它叫:正则化项(Regularization Term)。
公式到底在做什么?可以简单理解成:
第一部分:让模型尽量拟合数据
第二部分:惩罚过大的参数
模型现在要同时满足两个目标:预测准确和参数不要太夸张。
λ(Lambda)到底控制什么?
λ是一个权重,它决定模型更在意拟合数据,还是保持简单。
情况一:λ = 0,没有约束。
结果:参数可以无限大,极易过度拟合。
情况二:λ 非常大,参数被强行压小。
结果: 模型接近一条直线,出现欠拟合。
情况三:合适的 λ 模型
结果:既能学习规律,又不会过度复杂。
这就是我们真正想要的状态。
为什么只约束 w,不约束 b?
很多人第一次看到会疑惑:为什么不限制偏置项 𝑏 ?
原因很简单:
𝑤 控制曲线的形状和复杂度, 𝑏 只是整体平移。限制 b 对复杂度几乎没有影响。
所以工程实践里通常只正则化参数 w。
逻辑回归中的正则化
逻辑回归的成本函数本来是:
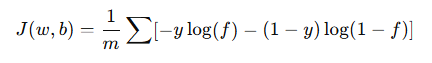
加入正则化后:
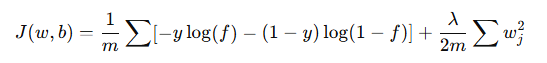
注意跟线性回归相比:前半部分不同,后半部分完全一样
这其实说明一件很重要的事:正则化不是某个模型的技巧,而是一种通用思想。
Python 示例:正则化如何让曲线变平滑
下面这个例子演示,同样的数据,不同 λ 下模型的变化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import Ridge
# 数据
np.random.seed(0)
x = np.linspace(0, 10, 20)
y = np.sin(x) + np.random.normal(0, 0.2, size=x.shape)
# 多项式特征
poly = PolynomialFeatures(degree=8)
X_poly = poly.fit_transform(x.reshape(-1,1))
# 不同正则化强度
lambdas = [0, 1, 100]
plt.scatter(x, y, color='black')
for l in lambdas:
    model = Ridge(alpha=l)
    model.fit(X_poly, y)
    y_pred = model.predict(X_poly)
    plt.plot(x, y_pred, label=f"lambda={l}")
plt.legend()
plt.title("Regularization Effect")
plt.show()
生成的图片如下图所示:
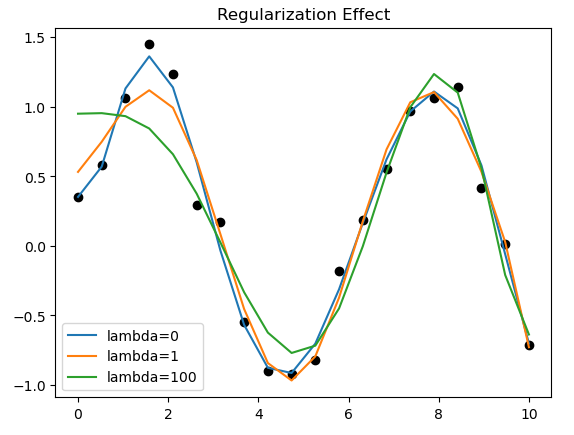
你会看到:
λ=0:曲线剧烈波动(过拟合)
λ变大:曲线逐渐平滑
λ过大:开始欠拟合
这就是正则化在真实世界中的样子。
写到这里,其实正则化并不只是一个公式,而是一种很重要的思维方式:模型并不是越复杂越好,而是要在“表达能力”和“稳定性”之间找到平衡。
线性回归和逻辑回归看起来不同,但在正则化的框架下,它们都在做同一件事——通过约束参数,让模型学会克制,从而真正具备面对新数据的能力。
很多时候,机器学习的进步,并不是让模型学得更多,而是让它学得刚刚好。
附录:本文涉及的专有名词中英文对照(标红为最核心)