CHAPTER 07 / 37
特征缩放、收敛与学习率:梯度下降为什么会忽快忽慢?
当你发现模型训练忽快忽慢、甚至不收敛时,其实问题不在算法,而在你是否真正理解了功能缩放、学习率与梯度下降背后的优化本质。
前几篇文章,我们已经把机器学习最核心的一条链路走通了:
-
定义模型
-
定义误差(Cost Function)
-
用梯度下降不断更新参数
但真正开始训练模型之后,但真正开始训练模型后,很多人会遇到三个非常真实的问题:
-
为什么同样的代码,有时候训练快,有时候几乎不动?
-
怎么判断模型真的在变好,而不是“假装学习”?
-
学习率(learning rate)到底该怎么选?
这一篇,我们把这三个问题一次讲透。
为什么梯度下降有时候“走得很慢”?
假设你在做一个共享单车需求预测模型,希望根据以下特征预测每天骑行人数:
x₁:城市人口(单位:万人) → 范围 50 ~ 2000
x₂:平均气温(℃) → 范围 -5 ~ 35
x₃:是否周末(0 或 1)
你可能没意识到:三个特征的数量级完全不同。
1、参数大小会被特征尺度“反向影响” 模型:
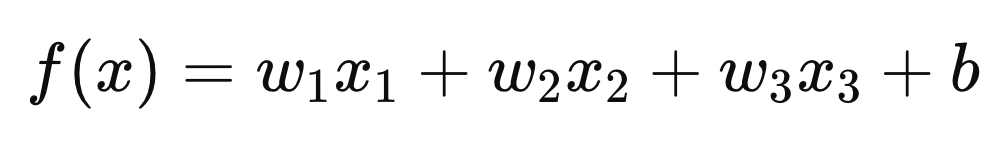
因为人口数量很大,合理的𝑤1通常很小。而周末只有0或1,𝑤3反而会很大。结果是什么?——
2、梯度下降路径会变得“又高又窄”
想象成本函数像一个山谷:一个方向非常陡,一个方向非常平缓。
梯度下降会出现左右疯狂来回跳,但前进很慢的情况,就像在一个狭长峡谷里来回撞墙。
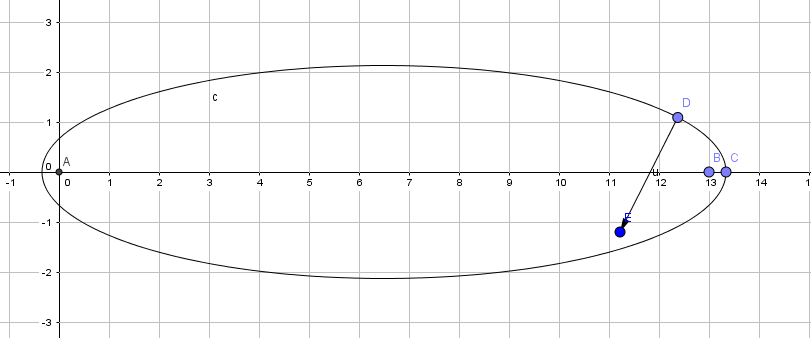
当不同特征的尺度差异很大时(比如一个特征是 1000 级别,另一个是 0~1):成本函数(Cost Function)的等高线会变成细长椭圆,某些方向非常陡,某些方向非常平缓。
结果就是参数更新在陡峭方向变化巨大,在平缓方向变化很小。
3、为什么会出现“来回弹跳”?
梯度下降每次都沿最陡方向走。
但在这种狭长地形中,梯度几乎垂直于谷底,每一步都会跨过最低点,于是路径变成:
左 → 右 → 左 → 右 → 左 → 右看起来很努力,但真正朝目标前进的距离非常小。
这就是你看到的 zig-zag(锯齿形)下降。
如果某个特征值特别大:对应梯度也会特别大,参数更新幅度被放大。
于是,一个方向步子过大,另一个方向几乎不动,优化过程被严重拉扯。
4、为什么感觉像“走得很慢”?
注意一个反直觉的点:每一步移动距离其实很大。
但因为方向不对,大部分移动都是横跳,不是向下,所以整体收敛速度很慢。
因此,我们需要功能缩放。
功能缩放(Feature Scaling)到底在做什么?
很多人第一次听到功能缩放,会以为这是一个“数据清洗的小技巧”。但其实,它直接决定:梯度下降能不能高效地找到最优解。
功能缩放的本质,是让模型里的每一个参数,以相似的速度学习。
1、为什么必须做功能缩放?
我们先回到梯度下降的更新公式:
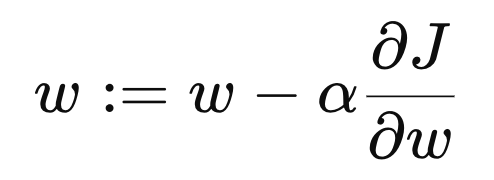
注意这里的关键:
参数更新大小 = 学习率 × 梯度
问题来了:梯度大小由什么决定? 答案是:特征值的大小。
比如预测某个城市的共享单车需求,人口特征的数值非常大因此对应的梯度巨大,周末的特征值只有0和1因此对应的梯度极小。
这会导致梯度下降更新时,优化过程出现左右震荡、路径弯曲和收敛变慢。
这不是模型的问题,而是“单位不一致”的问题。
2、功能缩放真正改变了什么?
很多人误解为:功能缩放改变了数据。
其实更准确的说法是:它改变了优化空间的几何形状。
没缩放时,成本函数等高线的形状是细长椭圆。这意味着:一个方向很陡,一个方向很平,梯度下降只能来回跳。
缩放之后等高线变成接近圆形。会让每个方向更新幅度接近,梯度下降可以直线前进。
3、功能缩放 ≠ 提高模型能力
这是一个非常重要的认知。
功能缩放不会提升模型表达能力,不会改变最终最优解。
它只做一件事:让你更快、更稳定地到达那里。
三种主流功能缩放方式
1、范围缩放(Min-Max Scaling)
公式如下:
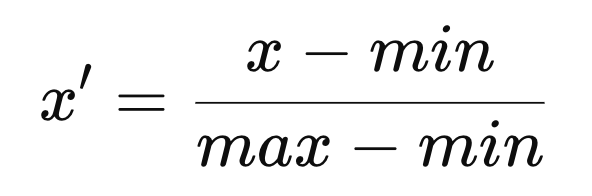
结果:所有数据被压缩到0~1
你在告诉模型:不管单位是什么,大家都统一用百分比表示。
优点:简单直观,对神经网络常见
缺点:对异常值(outlier)非常敏感,如果出现一个极大值,所有数据都会被压缩得很小。
2、均值归一化(Mean Normalization)
公式如下:
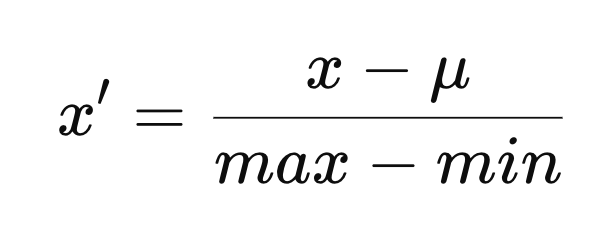
核心变化是,数据围绕0对称,有正有负。
为什么要减均值?因为梯度下降在0附近最稳定。
当数据整体偏大时,参数会产生不必要的偏移。相当于先把坐标系移动到中心,再进行缩放。
3、Z分数标准化/零均值标准化(Z-score Normalization)
公式如下:
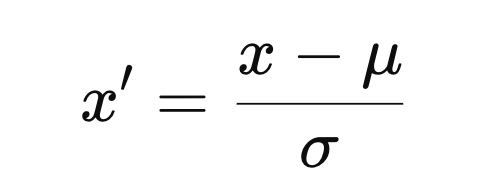
其中:μ是均值,σ是标准差。
为什么它最常用?因为它不是依赖极值,而是使用“统计分布”来缩放。
结果:均值 = 0 ,标准差 = 1
Z-score 的含义是:当前数据离平均值有多少个“标准差”。
例如:
x = 2 → 比平均高 2 个标准差模型学习的不是绝对数值,而是相对偏离程度。
相比范围缩放:不怕异常值,数值更稳定,更适合梯度下降。
这也是为什么:90%的机器学习项目默认使用Z-score。
以下是一个Python实现Z-score标准化的例子,每一列(每个特征)单独计算均值和方差。
import numpy as np
def zscore_normalize(X):
    mu = np.mean(X, axis=0)
    sigma = np.std(X, axis=0)
    X_norm = (X - mu) / sigma
    return X_norm, mu, sigma
为什么功能缩放本质上是在做预条件化(Preconditioning)?
如果你已经理解了功能缩放可以让梯度下降变快,那么下一步真正高级的问题是: 为什么仅仅改变数据尺度,就能改变优化速度?
答案来自优化理论里的一个关键词:Preconditioning(预条件化)。
功能缩放的本质不是“缩放数据”,而是改变参数空间的几何结构,让优化问题更容易被梯度下降解决。换句话说,功能缩放是一种最简单的预条件化。
在数值优化中,预条件化的核心思想是:在优化之前,对问题做一次坐标变换,让它变得更“好解”。
你可以理解为,不是改变目标,而是改变“看问题的角度”。
因此,很多人认为功能缩放是为了让数值范围一致。这是对的,但太浅。更深的理解是,我们不是在缩放数据,而是在改变优化问题的条件数(Condition Number)。
条件数是什么? 简单理解:优化问题有多“难走”。
条件数大 → 极难优化
条件数小 → 容易收敛
功能缩放的核心作用是降低条件数。
因此,功能缩放的本质不是数据处理,而是通过改变坐标系,对优化问题进行预条件化,让梯度下降能够沿着更合理的几何路径收敛。
如何判断梯度下降是否收敛?
真正的工程师不会盲跑10000次迭代。
他们会看一个东西:学习曲线(Learning Curve)。
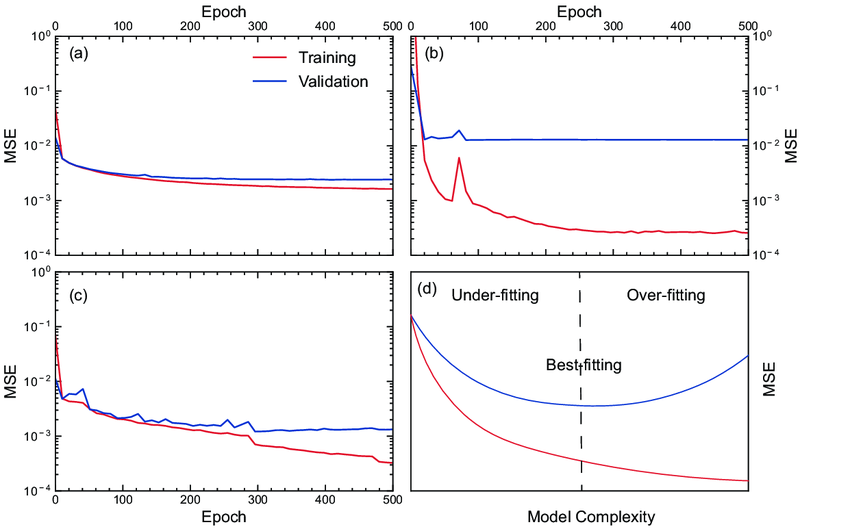
学习曲线的横轴表示迭代(iteration),纵轴表示成本(cost J)。
正常收敛长这样:
持续下降 → 慢慢变平这说明:模型在学习,且已接近最优。
危险信号1:
上下震荡:
下降 → 上升 → 下降 → 上升这通常意味着:学习率太大。
危险信号 2:
持续上升这几乎可以确定,要么是学习率过大,要么是代码写错(例如忘记减号)。以下是通过Python记录训练过程的示例,你真正需要关注的不是参数,而是cost_history。
cost_history = []
for i in range(iterations):
    predictions = X @ w + b
    error = predictions - y
    dj_dw = (1/m) * (X.T @ error)
    dj_db = (1/m) * np.sum(error)
    w = w - alpha * dj_dw
    b = b - alpha * dj_db
    cost = (1/(2*m)) * np.sum(error**2)
    cost_history.append(cost)
学习率:机器学习里最被低估的超参数
学习率 α 决定了每一步迈多大。
α 太大,会导致一步跨过最优点,来回震荡。
α 太小,会导致梯度下降非常稳定,但慢得像静止。
如何选择学习率
真实项目中,我们不会细调小数点。而是按数量级试(指数级搜索)。
Step 1:准备一组候选学习率。
learning_rates = [ 1e-4, 3e-4, 1e-3, 3e-3, 1e-2, 3e-2, 1e-1 ]注意规律:每次大约 ×3。
Step 2:每个学习率只跑少量迭代。
不要一开始就训练完整模型。 而是每个alpha跑50~200次,迭代目的不是训练模型,而是观察趋势。
Step 3:看学习曲线。
你要找的是下降最快,但仍然稳定的α。
通常最优值 ≈ 能稳定训练的最大α。
举例来说,如果:α = 0.01 正常,而α = 0.03 发散。那么最佳值往往在 0.01 ~ 0.03 之间,直接选0.01 或 0.02。
核心总结
梯度下降不是数学公式,它是一种动态系统:
-
功能缩放 → 改变地形
-
学习率 → 决定步伐
-
学习曲线 → 告诉你是否走对方向
机器学习的大多数优化问题,本质都是在复杂地形中找到稳定下降的路径。
这一篇,我们从梯度下降真正的工程问题出发,理解了为什么模型有时“走得很慢”,为什么功能缩放能够改变优化路径,以及如何通过学习曲线判断是否收敛、用工程方法选择合适的学习率。
看似只是几个参数和公式的调整,本质上却是在重新塑造优化问题的几何结构,让算法能够以更合理的方式接近答案。
机器学习并不是简单地把数据丢进模型,而是不断理解数据、优化和计算之间的关系。
当你开始意识到功能缩放是一种预条件化,学习率是一种对探索速度的控制时,你已经不再只是“使用算法”,而是在理解算法如何思考。
附录:本文涉及的专有名词中英文对照(标红为最核心)