CHAPTER 09 / 37
逻辑回归与分类:模型是如何学会“做判断”的?
逻辑回归的本质,是用一条概率曲线,在混乱的数据中划出清晰的边界。
上一节,我们让线性模型学会了拟合曲线。
通过特征工程,我们发现:很多复杂问题,其实只是特征表达的问题。但无论多复杂,我们做的仍然是预测一个数字。
现实世界里,还有另一类更常见的问题:这条交易是正常还是异常? 用户会不会点击广告? 设备是否即将故障? 这些问题的答案不是一个连续数值,而是:
是 / 否这就是今天的主题:分类(Classification)。
为什么线性回归不适合分类?
假设我们想要预测,长时间戴耳机的用户是否会续费会员,我们想预测:
y = 1 → 会续费
y = 0 → 不会续费
假设只有一个特征:x = 每周听歌时长(小时)。
如果直接用线性回归,模型可能长这样:𝑦 = 𝑤𝑥 + 𝑏 。
问题来了:线性回归可能输出:1.4、 -0.3、 2.1
但现实中:用户不会“续费1.4次”。更严重的问题是,如果新增一个极端用户(听歌时间特别长),整条拟合直线会被拉偏,导致分类边界被错误移动。
这说明线性回归本质上不是为分类设计的。
有没有一种模型输出永远在0和1之间?可以被理解为概率?这就是逻辑回归。
逻辑回归到底是什么?
虽然名字里有Regression(回归),但它实际上是分类算法。
核心思想只有两步:
Step 1:先算一个线性结果
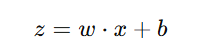
Step 2:把 z 压缩到 0~1
使用一个特殊函数:Sigmoid(S型函数)
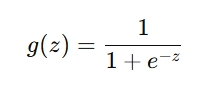
为什么是它?
因为它天然满足:输出范围在0和1之间,并可解释为概率。
用Python画出Sigmoid(核心示意图)
以下述代码为例:
import numpy as np
import matplotlib.pyplot as plt
def sigmoid(z):
    return 1 / (1 + np.exp(-z))
z = np.linspace(-10, 10, 200)
y = sigmoid(z)
plt.figure(figsize=(7,4), dpi=120)
plt.plot(z, y)
plt.title("Sigmoid Function")
plt.xlabel("z")
plt.ylabel("sigmoid(z)")
plt.grid(True)
plt.show()
可以看到运行结果如下图:
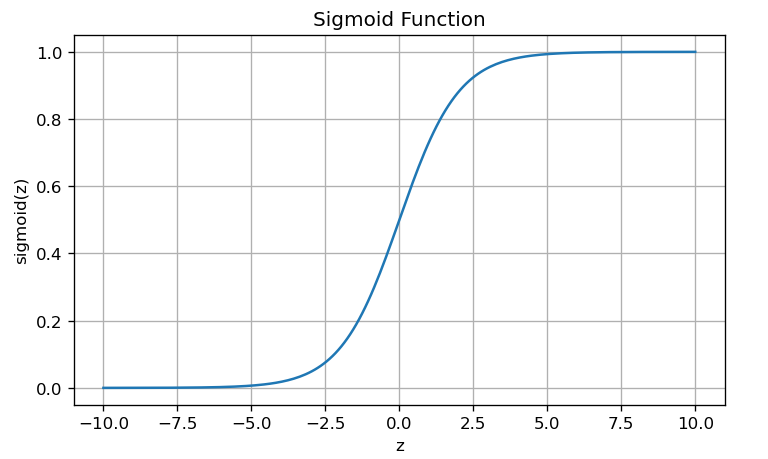
此刻你看到的是经典的S曲线:
z 很小 → 接近 0
z 很大 → 接近 1
z = 0 → 输出 0.5
这意味着:模型正在做“概率映射”。
逻辑回归真正输出的是什么?
很多人第一次学都会误解,逻辑回归输出的不是类别,而是P(y=1∣x) ,一个浮点数,也就是属于正类的概率。
例如:
模型输出 = 0.8含义是:有80%的概率会续费。
那么通过这个输出的结果,如何变成最终判断呢?
通常我们需要设置一个阈值:
≥ 0.5 → 预测为 1
< 0.5 → 预测为 0
注意一个重要结论,因为 sigmoid(0)=0.5,所以:分类边界 = wx + b = 0
这就是决策边界(Decision Boundary)。
可视化案例:逻辑回归 vs 数据
我们生成一个简单分类数据。
1、生成示例数据:
np.random.seed(0)
x = np.linspace(0,10,40)
y = (x > 5).astype(int)
X = x.reshape(-1,1)
2、训练逻辑回归:
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(X, y)
y_prob = model.predict_proba(X)[:,1]
3、matplotlib 可视化:
plt.figure(figsize=(8,5), dpi=120)
plt.scatter(x, y, c='red', label='Data')
plt.plot(x, y_prob, label='Logistic Curve')
plt.axhline(0.5, linestyle='--', label='Threshold=0.5')
plt.xlabel("Listening Hours")
plt.ylabel("Probability")
plt.title("Logistic Regression Classification")
plt.legend()
plt.show()
运行结果如下图:
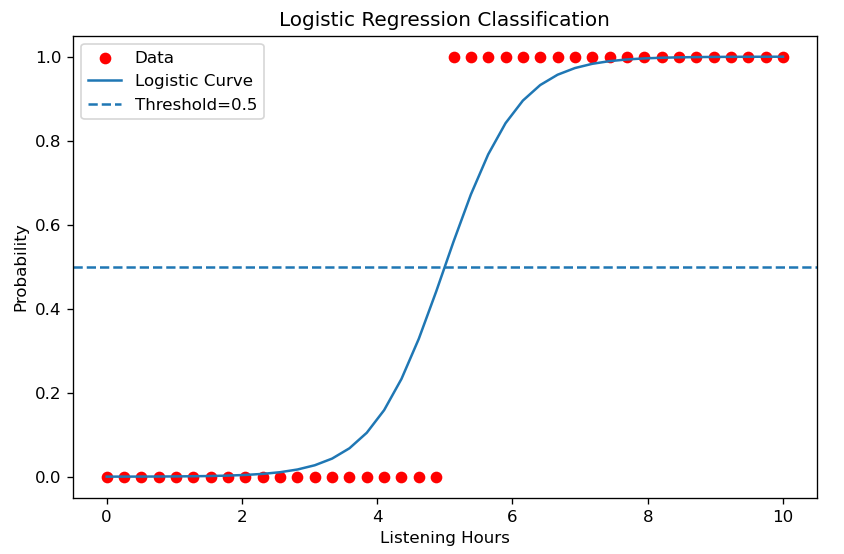
图里你会看到:
红点:真实类别
S曲线:概率变化
0.5线:决策边界
这一张图几乎可以讲懂逻辑回归。
决策边界:模型真正的核心
很多人第一次学习逻辑回归时,会把注意力放在:Sigmoid 曲线和概率输出。
但从工程角度看,真正重要的其实只有一件事:模型在学习一条“分界线”。
这条线,就是决策边界(Decision Boundary)。
1、从概率到边界:关键一步
我们已经知道,逻辑回归输出:
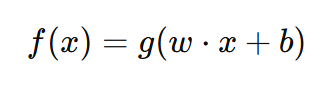
其中:
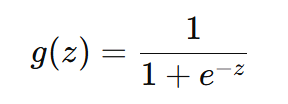
Sigmoid 有一个非常重要的性质:当 z = 0 时,输出正好是 0.5。而我们分类的规则是:
概率 ≥ 0.5 → 类别 1
概率 < 0.5 → 类别 0
所以真正决定分类的不是sigmoid,而是 z = wx + b 是否大于 0。
逻辑回归预测:
𝑦 = 1 当 𝑤 ⋅ 𝑥 + 𝑏 ≥ 0
𝑦 = 0 当 𝑤 ⋅ 𝑥 + 𝑏 < 0
那么边界是什么? 就是:𝑤 ⋅ 𝑥 + 𝑏 = 0 ,这条等式对应的几何形状就是决策边界。
2、一维情况:最容易理解
假设只有一个特征:
x = 每周听歌时长模型: 𝑧 = 𝑤 𝑥 + 𝑏
决策边界就是一个点,当:𝑤 𝑥 + 𝑏 = 0。
可以解出: 𝑥 = − 𝑏 / 𝑤
这意味着:模型其实只是找到一个临界点。
左边 → 不续费
右边 → 会续费
3、二维情况:边界变成一条线
如果我们有两个特征:
x₁ = 听歌时长
x₂ = 登录频率
模型变成:
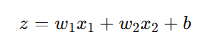
则决策边界为:
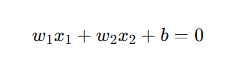
这是一个二维平面中的直线。
模型其实在做:把平面切成两半。 一侧预测 1,另一侧预测 0。
通过运行如下代码:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
np.random.seed(0)
X = np.random.randn(100,2)
y = (X[:,0] + X[:,1] > 0).astype(int)
model = LogisticRegression()
model.fit(X, y)
w = model.coef_[0]
b = model.intercept_[0]
x_vals = np.linspace(-3,3,100)
y_vals = -(w[0]*x_vals + b)/w[1]
plt.figure(figsize=(6,6), dpi=120)
plt.scatter(X[:,0], X[:,1], c=y)
plt.plot(x_vals, y_vals, color='red', label='Decision Boundary')
plt.xlabel("x1")
plt.ylabel("x2")
plt.title("Logistic Regression Decision Boundary")
plt.legend()
plt.show()
可以得到下面的图:
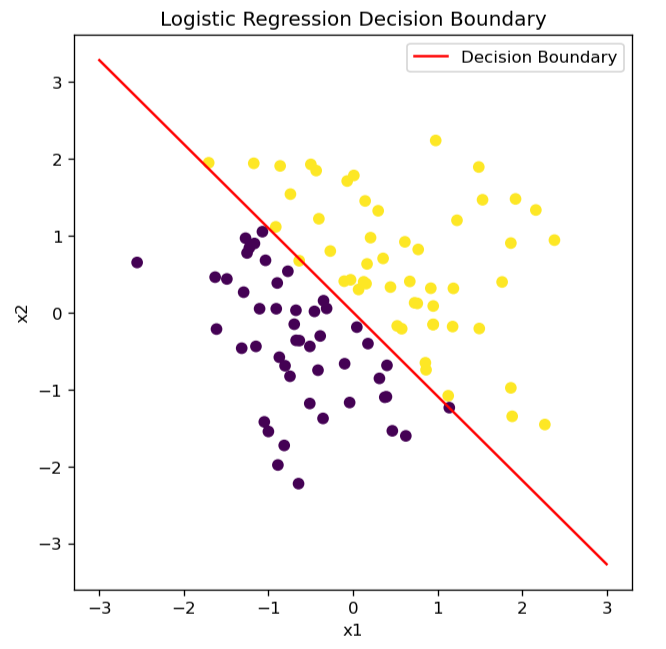
你会看到:模型自动找到一条线,把两类数据尽量分开。
这就是训练的本质——逻辑回归真正优化的不是概率曲线,而是边界的位置和方向。换句话说:参数 w 和 b 决定了边界的形状。
如果加入多项式特征:
x₁², x₂², x₁x₂决策边界可以变成:圆形、椭圆和更复杂曲线,但本质上都跟上面一样。
你会发现:
逻辑回归 + 特征工程 ≈ 非线性分类器为什么逻辑回归仍然被广泛使用?
很多人以为逻辑回归是“入门算法”。
但现实里,广告点击预测、风控系统、推荐系统等大量场景仍在使用该算法。
原因很简单:可解释性强、训练速度极快以及概率输出自然。
很多业务决策需要概率,而不是类别。
这一篇,我们从为什么线性回归不适合分类开始,引入了逻辑回归,并通过 Sigmoid函数理解了模型如何把线性结果转化为概率,再通过决策边界理解模型真正的分类方式。
真正值得记住的不是公式,而是一个思维转变:机器学习并不总是在预测一个具体的值,有时候,它只是试图在复杂的世界里划出一条边界,把不同类型的事物区分开来。
逻辑回归的本质,是用一条概率曲线,在混乱的数据中划出清晰的边界。
附录:本文涉及的专有名词中英文对照(标红为最核心)