CHAPTER 03 / 37
梯度下降:参数是如何被推向最优的?
一篇文章讲清楚,参数是如何通过梯度下降,被推向最优的。
在上一篇,我们已经完成了两件事:
1、定义了模型:
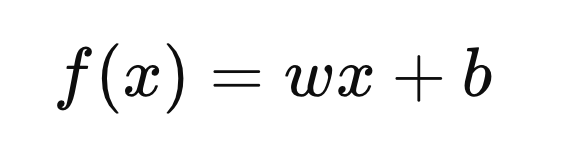
2、定义了成本函数:
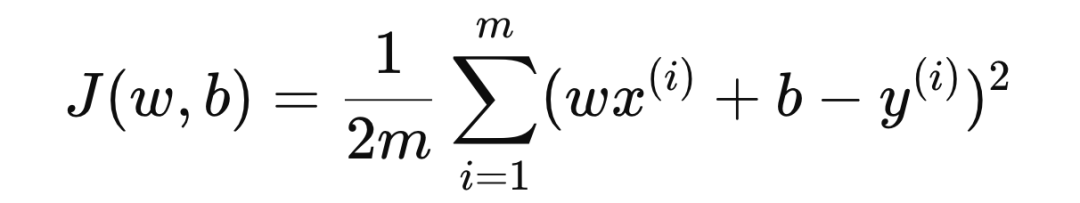
我们知道目标是:
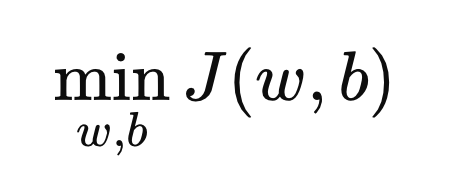
但问题仍然存在——如何真正找到那个让成本函数最小的参数组合?
这一篇,我们讲清楚这个过程。
优化问题的本质
我们面对的是一个函数最小化问题。如果只考虑一个变量w,那么我们要做的是:
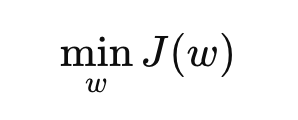
从数学角度看,这属于连续函数的极值问题。 如果画出 J(w) 的图像,大致会是一个开口向上的曲线。
在极小值点,曲线切线是水平的,且导数等于0。
这在数学上写作:
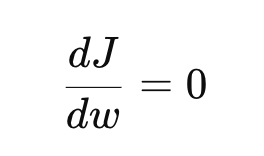
这说明,如果我们能找到导数为零的位置,就找到了极小值。
对于线性回归,确实存在一种解析解(正规方程)可以直接解出参数。但梯度下降的意义在于:它是一种通用方法,可以用于无法解析求解的复杂模型。
因此我们关注的是一种“数值逼近”的思路,而不是代数解法。
梯度下降的直觉:每一步都往最陡的下坡走
想象你闭着眼站在山坡上,你不知道最低点在哪,但你可以感受脚下的坡度朝——然后向“最陡的下坡方向”,迈一小步。就是梯度下降,数学表达是:
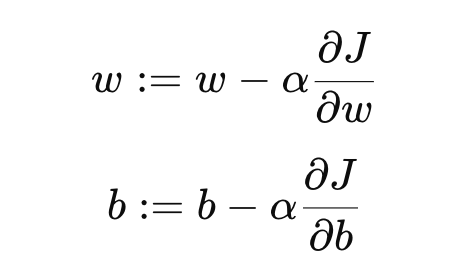
其中,α是学习率,表示步子多大;∂J/∂w是对于w(b)求导,表示当前坡度。关于公式的推导,第3、4节会详细介绍,如果没学过微积分可以直接跳过或者问AI。
为什么“导数”能告诉我们方向?
我们回到最简单的单变量情况。设当前参数是𝑤,我们考虑往前走一个很小的变化Δ𝑤。根据一阶泰勒展开:
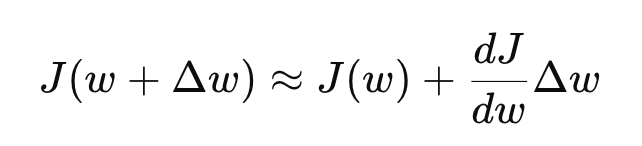
这条式子的含义是:当前函数值加上斜率 × 位移。如果我们希望函数值变小,就必须让:
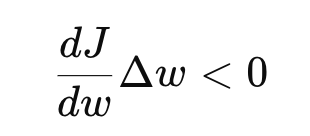
因此,若导数为正 → Δw应为负,若导数为负 → Δw应为正。这说明应当沿着“负导数方向”移动。于是我们设定:
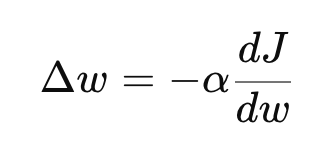
其中α是一个正数,用来控制步长大小。 代入更新规则:
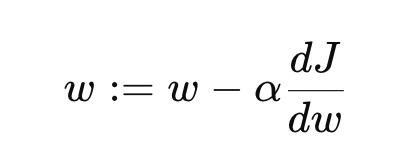
以上就是梯度下降公式的来源。它不是经验规则,而是来自函数局部线性近似的结果。
线性回归梯度的完整推导
现在回到我们的成本函数:
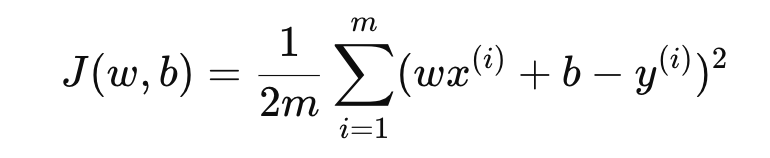
我们对 w 求偏导。 首先对平方项求导:
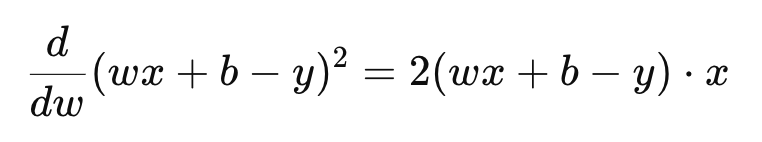
然后乘上前面的系数1/2𝑚,2 抵消:
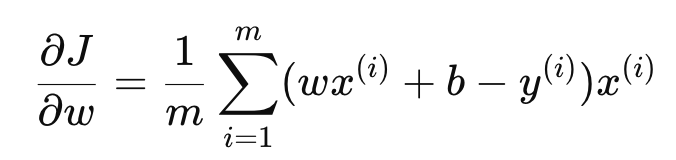
同理,对 b 求偏导:
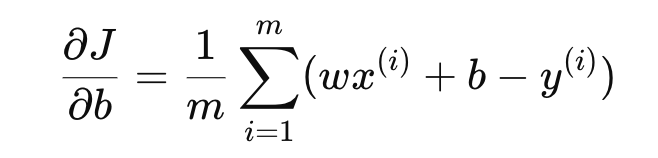
这两个表达式统称为“梯度”。
梯度的含义是:当前参数下,成本函数对参数变化的敏感程度。
一个最直观的情况:只有一个参数时
假设我们令 𝑏 = 0,成本函数 𝐽 ( 𝑤 )是一个开口向上的抛物线。
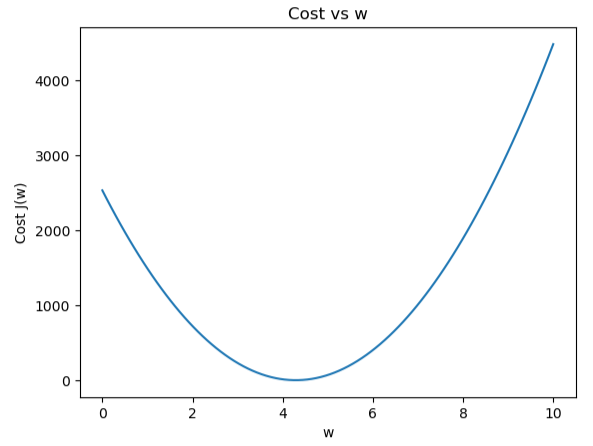
此时梯度下降的更新公式是: 𝑤 : = 𝑤 − 𝛼 𝐽 ′ ( 𝑤 )
现在只看“导数的符号”就足够了。
如果你在抛物线右侧:
-
导数为正(斜率向上)
-
更新公式变成 𝑤 − 𝛼 × 正数
-
结果是 w 变小,向左移动。
如果你在抛物线左侧:
-
导数为负(斜率向下)
-
更新公式变成 𝑤 − 𝛼 × 负数,等于加上一个正数,
-
结果是 w 变大,向右移动。
无论从哪一侧出发,只要学习率合适,都会被“推向”最低点。
当到达最低点时, 𝐽 ′ ( 𝑤 ) = 0 ,更新不再改变参数,算法自然停止。
这就是梯度下降在抛物线(也就是线性回归成本函数)上必然收敛的最核心原因。
梯度下降为什么会收敛?
再回到线性回归的成本函数,它是平方误差的形式:
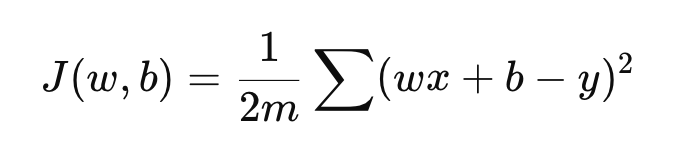
这个函数有一个非常关键的性质:它是一个凸函数(convex function)。
直观理解就是:它像一个碗,只有一个最低点,没有多个“陷阱” ,没有局部极小值。
在这种情况下,只要你每一步都沿着负梯度方向走,并且步子(学习率)不是过大,就一定会朝着碗底移动。
更形式化一点说:梯度指向函数上升最快的方向,负梯度指向函数下降最快的方向,对于凸函数,任何一点的负梯度方向都指向全局最小值。
因此,在凸优化问题中,梯度下降只要满足合理的学习率条件,就可以保证收敛到全局最优解。
这也是为什么在线性回归中,梯度下降不会“卡住”。
那为什么有时会失败?
问题出现在更复杂的模型中。
当模型变成神经网络时,成本函数往往不是一个简单的“碗”,而可能是这样的地形——有很多局部低谷,有很多平坦区域,有复杂的弯曲结构。
在这种情况下:梯度下降可能停在局部最小值,可能在平坦区域走得很慢,学习率过大还会震荡。
但即便如此,梯度下降仍然是主流方法。
因为在高维空间中,一个有趣的现象是,局部最小值和全局最小值往往性能接近。
这也是深度学习能大规模成功的原因之一。
学习率为什么至关重要?
α(学习率)控制每一步移动的大小。
如果 α 太小:
-
收敛非常慢
-
需要大量迭代
如果 α 太大:
-
可能跨过最优点
-
甚至发散
数学上可以证明,在凸函数情况下,只要:0 < 𝛼 < 2/𝐿 (L 是梯度的 Lipschitz 常数),梯度下降就能保证收敛。
当然,实际应用中我们通常通过实验调节学习率,而不是手动计算 L。
梯度为0时会发生什么?
当梯度等于 0 时:∂ 𝐽 / ∂ 𝑤 = 0 ,则更新公式变成:𝑤 : = 𝑤 ,参数不再改变。
这意味着,梯度下降的停止条件,本质就是梯度趋近于0。
这也解释了为什么训练后期步子会越来越小——因为接近最低点时,导数本身就变小了。
即使学习率保持不变,更新幅度也会自然减小。
逻辑上的完整闭环
现在我们回顾一下整个过程:
1、定义模型
2、定义误差函数
3、对误差函数求导
4、用负梯度更新参数
5、重复直到梯度接近0
这五步构成了机器学习训练的基本框架。
线性回归之所以重要,不是因为它本身有多强,而是因为它让我们完整经历了这个流程。
当你理解了梯度下降的推导、收敛条件和实际表现,再看到更复杂的模型时,本质已经不会变。
这一篇的数学内容确实比前两篇多一些。如果推导过程看起来有些抽象,可以回到最简单的图形直觉——想象一条抛物线,想象自己站在坡上,理解“斜率决定方向”这一点,其实就已经抓住了梯度下降有效性的核心。公式只是把这种直觉写得更精确而已。
如果对推导细节感兴趣,可以借助 AI 或教材再深入拆解一遍,但真正重要的是理解“为什么它会往低处走”。
对于非算法工程师来说,理解梯度下降的意义并不在于自己去写优化器,而在于知道模型并不是凭空变好的,它是通过一轮一轮的误差修正逼近最优解。
尤其对产品经理而言,这意味着你在看一个模型效果时,脑子里应该有“目标函数、优化方向、收敛速度”等这些概念——模型表现不佳,往往不是“智能不够”,而是目标定义、数据质量或优化过程存在问题。理解这一层逻辑,才能真正和算法同事在同一个抽象层级上对话。
如果再抽象一层,这一篇文章围绕的其实只有三件事:
目标函数、方向信息(梯度)、步长控制(学习率)。
理解这三个概念,梯度下降的逻辑就已经完整了。
附录:本文涉及的专有名词中英文对照(标红为最核心)