CHAPTER 11 / 37
逻辑回归的梯度下降:为什么公式看起来一样,但本质完全不同?
真正决定模型能力的,从来不是那条分界线,而是它如何一步一步学会移动那条线。
在上一篇文章里,我们已经理解了:逻辑回归为什么不用平方误差,为什么要使用Log Loss。
这一篇我们继续往前一步,关于逻辑回归的梯度下降。
但真正要回答的问题是:为什么逻辑回归的梯度下降公式,看起来和线性回归几乎一样?它们到底哪里不同?
公式一样,不代表模型一样
先直接给出逻辑回归的梯度下降公式:
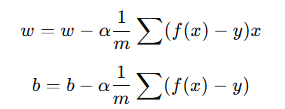
如果你学过线性回归,你会震惊:这不是一模一样吗?是的,梯度的形式几乎完全一致。
但真正不同的地方只有一个——
在线性回归中:𝑓(𝑥) = 𝑤𝑥 + 𝑏
在逻辑回归中:𝑓(𝑥) = 𝑠𝑖𝑔𝑚𝑜𝑖𝑑(𝑤𝑥 + 𝑏)
也就是说: 梯度公式一样,但模型输出变了。
而这一个变化,改变了一切。
一个更贴近真实世界的例子
假设你是产品负责人,要预测用户是否会在注册后24小时内完成首次分享。
特征可能包括:
x1 = 使用时长(分钟)
x2 = 浏览页面数
输出:
y = 1 → 会分享
y = 0 → 不会
到这里,你可能会有一个很自然的问题:既然这是分类问题,我们已经有了逻辑回归的成本函数,那么参数到底是怎么被更新出来的?
换句话说:模型是怎么一步一步学会把“会分享”和“不会分享”分开的? 这就回到了我们熟悉的工具——梯度下降。
为什么梯度下降还能继续用?
逻辑回归的成本函数是:
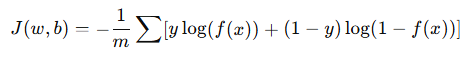
当我们对它求导后,神奇的事情发生了——最终结果仍然是 (f(x) - y)。
这也是为什么:线性回归可以用梯度下降,而逻辑回归也可以。
因为无论哪种模型:
梯度 = 预测值 - 真实值本质都是:看看你“错了多少”。
它们真正不同在哪里?
区别不是公式,而是误差的含义。
线性回归预测值可能是:
2.3、10.5、-4.2误差是:数值距离。
而逻辑回归预测值永远在:
0 ~ 1误差是概率差距。
线性回归在调整数值大小,而逻辑回归在调整决策边界的位置。
用Python看真正发生了什么
我们先生成一个简单数据。
import numpy as np
import matplotlib.pyplot as plt
np.random.seed(42)
x = np.linspace(0,10,50)
y = (x > 5).astype(int)   # 简单分类数据
定义Sigmoid函数:
def sigmoid(z):
    return 1/(1+np.exp(-z))
梯度下降(逻辑回归版本):
w = 0
b = 0
alpha = 0.1
cost_history = []
for _ in range(200):
    z = w*x + b
    f = sigmoid(z)
    # 梯度
    dw = np.mean((f - y)*x)
    db = np.mean(f - y)
    # 更新
    w -= alpha*dw
    b -= alpha*db
    # cost
    cost = -np.mean(y*np.log(f+1e-8)+(1-y)*np.log(1-f+1e-8))
    cost_history.append(cost)
成本下降过程:
plt.figure(figsize=(7,4))
plt.plot(cost_history)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.title("Logistic Regression gradient descent process")
plt.grid(alpha=0.3)
plt.show()
生成如下图所示,这张图比画Sigmoid更重要。
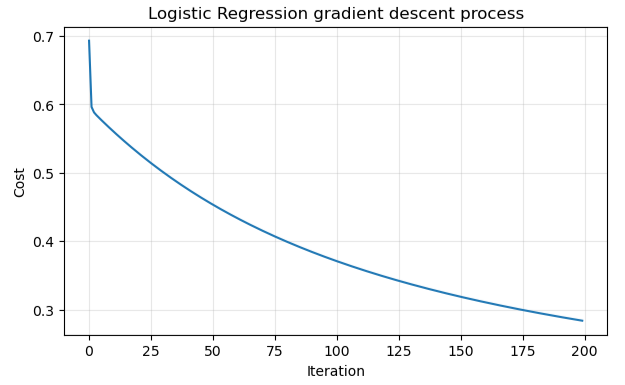
你会看到:
-
成本持续下降
-
曲线平滑稳定
这说明: Log Loss + 梯度下降 = 非常稳定的优化。
再看看模型如何移动决策边界:
plt.figure(figsize=(7,4))
plt.scatter(x,y)
xx = np.linspace(0,10,200)
yy = sigmoid(w*xx + b)
plt.plot(xx,yy)
plt.title("Logistic regression model after training")
plt.xlabel("x")
plt.ylabel("Probability")
plt.grid(alpha=0.3)
plt.show()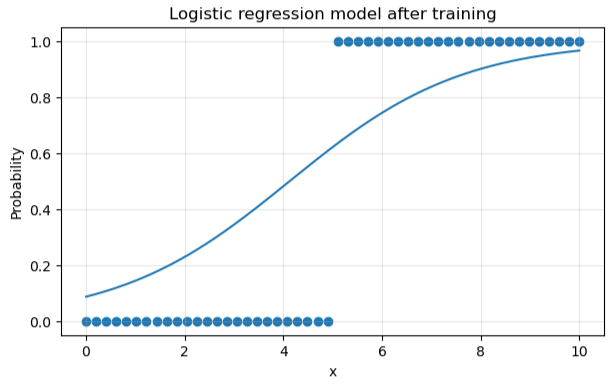
你会看到曲线不断调整,且0.5附近成为分类分界。
线性回归与逻辑回归的梯度下降区别
很多人以为:逻辑回归只是套了个Sigmoid,但真正的区别如下表:
用Scikit-Learn看一个逻辑回归案例
前面我们一直在讲:Logistic Loss、梯度计算和参数更新。但在真实工程里,同样的,这一切通常不会手写。
下面用一个极小的例子,看一下逻辑回归在实际代码里的样子。
假设我们要预测:用户是否会在首次使用后留下评论。
特征:
x1 = 使用时长
x2 = 浏览次数
标签:
y = 1(会评论)
y = 0(不会评论)
1、训练逻辑回归模型:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
# 示例数据
X = np.array([
    [0.5, 1.5],
    [1.0, 1.0],
    [1.5, 0.5],
    [3.0, 0.5],
    [2.0, 2.0],
    [1.0, 2.5]
])
y = np.array([0, 0, 0, 1, 1, 1])
# 创建并训练模型
model = LogisticRegression()
model.fit(X, y)
这里的fit(),本质上就是:
-
计算 Logistic Loss
-
求梯度
-
执行梯度下降
只是这些过程被封装起来了。
2、看看模型学到了什么:
print("w:", model.coef_)
print("b:", model.intercept_)
输出的参数,就是梯度下降不断更新后的结果。
也就是说,你前面推导的所有公式,最后都会收敛到这里。
3、用matplotlib可视化决策边界:
# 画数据点
plt.scatter(X[y==0][:,0], X[y==0][:,1], label="y=0")
plt.scatter(X[y==1][:,0], X[y==1][:,1], marker="x", label="y=1")
# 决策边界
w = model.coef_[0]
b = model.intercept_[0]
x_vals = np.linspace(0, 4, 100)
y_vals = -(w[0]*x_vals + b) / w[1]
plt.plot(x_vals, y_vals, label="decision boundary")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.legend()
plt.title("Logistic Regression Decision Boundary")
plt.show()
运行后结果如下图:
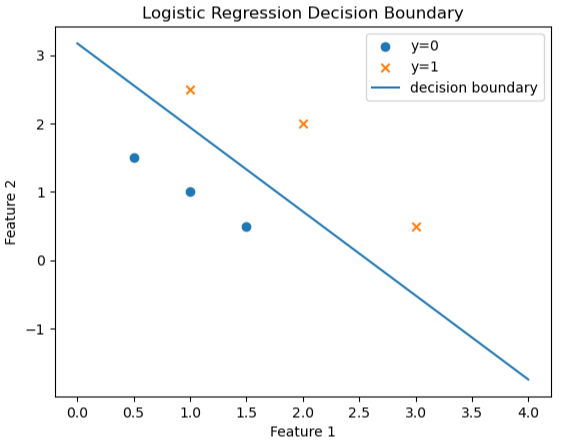
你会看到:一条分界线,且两侧分别是不同类别。这条线的位置,就是梯度下降优化的结果。
走到这里,其实我们已经把逻辑回归最核心的一块拼图补齐了。
从成本函数,到梯度的方向,再到参数一步一步被更新,你会发现一件很有意思的事情:逻辑回归并没有创造一种全新的优化方式,它只是换了一种看待错误的角度。
线性回归关心的是“差了多少”,而逻辑回归关心的是“你有多确定地错了”。
这一点变化,决定了它为什么适合分类,也决定了它为什么依然被大量使用。很多时候,算法真正的区别不在模型长什么样,而在它如何定义错误,以及如何一步一步修正自己。
附录:本文涉及的专有名词中英文对照(标红为最核心)