CHAPTER 06 / 37
多元线性回归与梯度下降:模型是如何同时学会多个参数的?
对前面内容做一次整体回顾:机器学习的本质,就是通过不断调整参数,让模型的预测误差一步步变小。
在上一篇,我们已经理解了两件关键的事情:
1、NumPy让数组计算变得高效
2、矢量化让代码从“逐个计算”变成“整体计算”
这一篇,我们把前面所有内容真正拼起来:用梯度下降训练多元线性回归。
换句话说,这是第一次,我们让模型开始真正“学习”。
先回顾:我们到底已经走到哪一步?
如果把整个系列看成一条主线,其实逻辑非常简单:
1、我们定义了线性模型
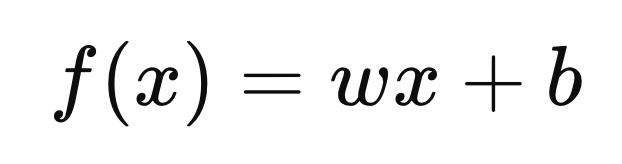
2、我们定义了成本函数(误差)
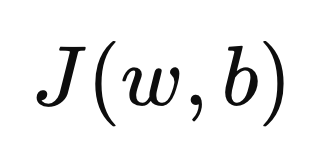
3、我们用梯度下降不断更新参数
4、然后发现——真实世界不只有一个特征。于是模型变成:
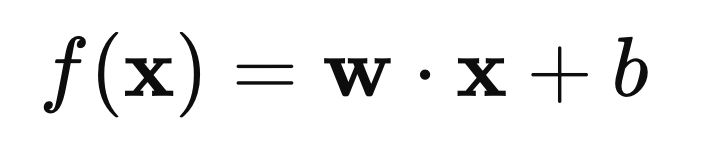
这里:
x:多个输入特征
w:多个权重参数
·:点积(dot product)
案例:预测一款智能手表的销量
假设我们想预测某款智能手表的销量,影响因素可能有:
-
广告投入(万元)
-
定价(元)
-
用户评分
-
上架时间(天)
那么一条训练数据可以写成:
x = [广告投入, 定价, 评分, 上架时间]模型就是:
销量 = w1*x1 + w2*x2 + w3*x3 + w4*x4 + b如果写成向量形式:
销量 = w · x + b这一步非常重要:模型没有变复杂,只是参数变多了。
多元线性回归的本质
很多人第一次看到“多元”会觉得复杂。其实只是:
-
单变量:一条线
-
多变量:一个高维平面
模型仍然是线性的。 只是:
w 从一个数字 → 一个向量
x 从一个数字 → 一个向量
预测:从循环到矢量化
先看最直观的写法:
def predict_loop(x, w, b):
    p = 0
    for i in range(len(x)):
        p += x[i] * w[i]
    return p + b
这完全正确。但 NumPy 可以直接写:
def predict(x, w, b):
    return np.dot(x, w) + b
这一步看似只是简化代码。
实际上,你已经把计算交给底层并行硬件,CPU / GPU 会同时计算多个乘法。
成本函数:本质没有变化
成本函数依然是:
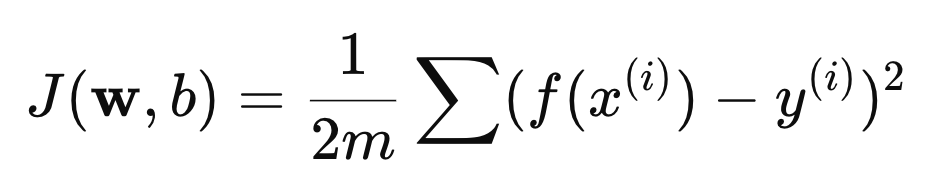
区别只有:
-
x 现在是向量
-
w 也是向量
计算流程仍然是:
-
做预测
-
计算误差
-
平方
-
求平均
梯度下降在多元情况下发生了什么?
单变量时:
更新一个 w现在:
更新 w1,w2,w3,...,wn也就是说,梯度下降不是一步,而是一组同步更新。更新公式:
w_j = w_j - α * ∂J/∂w_j
b   = b   - α * ∂J/∂b
核心思想完全没变:
-
看坡度
-
往下降方向走一点
真正重要的一步:梯度的向量化
如果用循环:
for j in range(n):
    dj_dw[j] += err * X[i,j]
但矢量化后:
err = np.dot(X[i], w) + b - y[i]
dj_dw += err * X[i]
注意这一行:err * X[i] 不是一个数字,而是一次性更新所有参数的方向。
这就是多元梯度下降的本质。
完整梯度下降结构(核心代码)
梳理核心的梯度下降代码如下,注意这只是一个示例,也无须搞懂代码具体怎么写出来的,只需要理解整个逻辑:
def gradient_descent(X, y, w, b, alpha, iterations):
    for i in range(iterations):
        dj_dw = np.zeros_like(w)
        dj_db = 0
        m = X.shape[0]
        for j in range(m):
            err = np.dot(X[j], w) + b - y[j]
            dj_dw += err * X[j]
            dj_db += err
        dj_dw /= m
        dj_db /= m
        w = w - alpha * dj_dw
        b = b - alpha * dj_db
    return w, b
看完这段代码,你会发现:
数学公式 → 代码几乎一一对应
并没有特别其他不同的地方。
阶段性回顾:构建机器学习认知地图
很多人在学习机器学习时,会出现一种感觉:每一篇都懂,但连不起来。
其实,这六篇内容并不是独立知识点,而是一步一步搭建出来的一条主线。
下面这张“认知地图”,就是整个第一阶段的完整结构。
第一篇:机器学习到底在做什么
-
监督学习:学习输入 → 输出关系
-
非监督学习:寻找数据结构
这里建立的是问题视角——机器学习不是算法,而是一种解决问题的方式。
第二篇:第一个可计算模型
-
我们第一次让机器做预测:f(x) = wx + b
-
同时引入成本函数 J(w,b)
这一步非常关键,学习 = 最小化误差。机器学习从“概念”变成了数学问题。
第三篇:模型如何自己找到答案
核心问题是参数怎么计算? 答案是:
-
看坡度(导数)
-
朝下降方向走
形成经典更新规则:
更新参数 = 前一次参数 - 学习率 × 梯度这是机器学习第一次出现“学习过程”。
第四篇:真实世界不止一个特征
模型升级:f(x) = w · x + b
变化只有一个:x 从数字 → 向量
但意义巨大: 机器开始同时理解多个维度的信息。
第五篇:真正的计算工具
我们开始回答一个现实问题:这些计算,Python真的能跑得动吗?
NumPy带来的核心改变:
-
数据变成数组
-
运算变成整体操作
思想升级:从“逐个计算” → “整体计算”。
第六篇(本文):真正的训练发生了
所有模块拼在一起:
-
多特征模型
-
NumPy向量
-
梯度下降更新
最终形成: 一个可以真正学习参数的系统。
可以把前六篇理解成下面这个结构:
问题定义
   ↓
模型表达(线性回归)
   ↓
误差衡量(成本函数)
   ↓
优化方法(梯度下降)
   ↓
模型扩展(多元特征)
   ↓
计算加速(NumPy & 矢量化)
   ↓
完整训练流程
以上,现代机器学习最核心的训练模式。
但真正重要的其实只有一句话:机器学习,本质是在不断调整参数,让误差变小。
到这一篇为止,我们已经把线性回归从一个简单公式,逐步走到了一个真正可以训练的学习系统:从模型表达、成本函数,到梯度下降,再到多元特征与矢量化计算,所有关键模块终于连成了一条完整的链路。
看起来内容越来越多,但核心始终没有改变——机器学习本质上只是让模型通过不断调整参数,逐渐逼近真实世界的规律。
理解这一点,比记住任何公式都更重要,因为当你看懂了“学习是如何发生的”,后面更复杂的算法,也只是在这个基础上的延伸与扩展。
附录:本文涉及的专有名词中英文对照(标红为最核心)