CHAPTER 23 / 37
偏差与方差:如何判断一个模型是太简单还是太复杂?
当模型效果不好时,判断问题出在偏差还是方差。
在前一篇文章中,我们讲了一个非常关键的问题:如何评估一个模型是否真的有效?但评估只是第一步。
真正困难的是:模型效果不好,我们下一步该做什么?
这是机器学习中最核心的能力之一。
而在所有方法中,有一个框架几乎可以解决80%的问题:偏差(Bias)与方差(Variance)
从一个案例出发
假设你在做一个电商推荐系统:预测用户是否会点击某个商品。你训练了一个模型,结果如下:
这个模型的问题是什么?再看另一个模型:
这两个模型的问题完全不同。
但如果没有一个分析框架,你很难判断:该优化数据?还是优化模型?
偏差与方差到底是什么?
我们用一个非常直观的方式来理解:
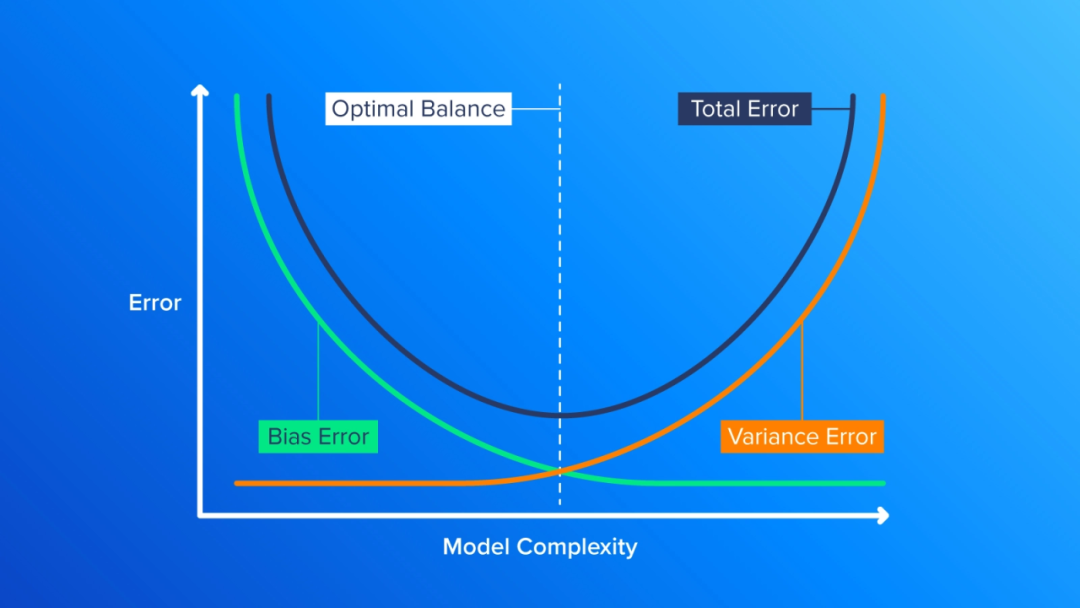
可以把模型理解成“拟合能力”
偏差(Bias)——模型太简单
特点是:
训练集效果差
验证集效果也差
本质是因为,模型没有学到规律。比如尝试用直线去拟合一个弯曲关系。
在上面的第一个例子中:70%与69%,这是典型的高偏差(Underfitting)情况。
方差(Variance)——模型太复杂
特点是:
训练集很好
验证集很差
出现这种情况是因为,模型记住了数据,而不是学到规律。就好像,模型只是把每个训练样本都“背下来”。
在上面的第二个例子中:98%与75%的结果表明,这是典型的高方差(Overfitting)。
一个非常实用的判断方法
你可以用一个非常简单的规则来判断:
如果训练集表现不好 → 高偏差
如果验证集明显更差 → 高方差
再加一个更专业一点的版本:
高偏差:J_train 很高
高方差:J_cv >> J_train
这其实就是机器学习中的“诊断工具”。
为什么我们需要“基准水平”
这里有一个很多人会忽略的问题:什么叫“高误差”?
例如:准确率85%,是好还是坏?答案是:看基准。
举个例子,假设是“语音识别”准确率如下:
基于上面数值,我们分析如下:
和人类接近 → 偏差不高
验证明显下降 → 方差问题
得出结论:高方差
再看另一个例子:
结论是,高偏差。
所以一个更完整的判断方式是:
偏差 = 训练误差 vs 理想水平
方差 = 验证误差 vs 训练误差
正则化到底在做什么?
现在进入本篇另一个核心:正则化(Regularization)。
正则化的本质是限制模型的复杂度。
1、正则化太强(λ 很大)
会让模型被强行变简单,结果是出现高偏差(学不动)。
2、正则化太弱(λ 很小)
会让模型自由度太高,结果是产生高方差(过拟合)。
3、正则化刚好
这使得模型复杂度适中,达成泛化能力最好的结果。
如下图所示:
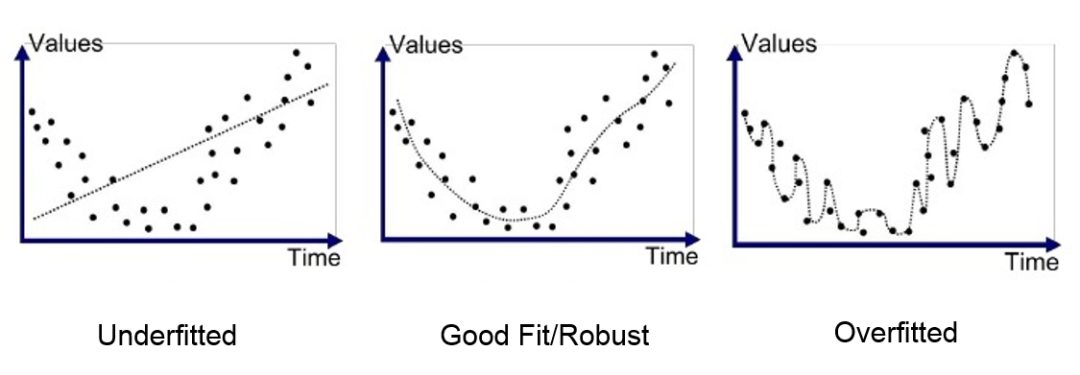
你会发现:
λ 太小 → 过拟合
λ 太大 → 欠拟合
如何选择合适的 λ?
答案依然是:用验证集(cross-validation)。
流程非常工程化:
1、选一组 λ 值(例如 0, 0.01, 0.1, 1, 10)
2、每个 λ 训练一个模型
3、在验证集上评估
4、选表现最好的
例如在神经网络中,代码如下:
Dense(64, activation='relu', kernel_regularizer=tf.keras.regularizers.l2(0.01))这里的0.01,就是 λ 。
你只需要调整这个值,就在控制模型复杂度。
在机器学习中,模型效果不好从来不是一个问题,问题在于:你是否知道为什么不好,以及下一步该做什么。
偏差与方差提供的,其实不是一个公式,而是一种决策框架:
如果模型连训练数据都学不好 → 提升能力(降低偏差)
如果模型只在训练数据上表现好 → 提升泛化(降低方差)
而正则化,则是你手中最直接的调节工具之一。
从更本质的角度看,机器学习的过程,其实是在不断寻找一个平衡点:既不过度相信数据,也不过度怀疑数据。而偏差与方差,正是这个平衡的刻度。
附录:本文涉及的专有名词中英文对照(标红为最核心)